Loading page
간격 반복과 FSRS게시일
FSRS vs SM-2: 스케줄링 알고리즘이 중요한 이유
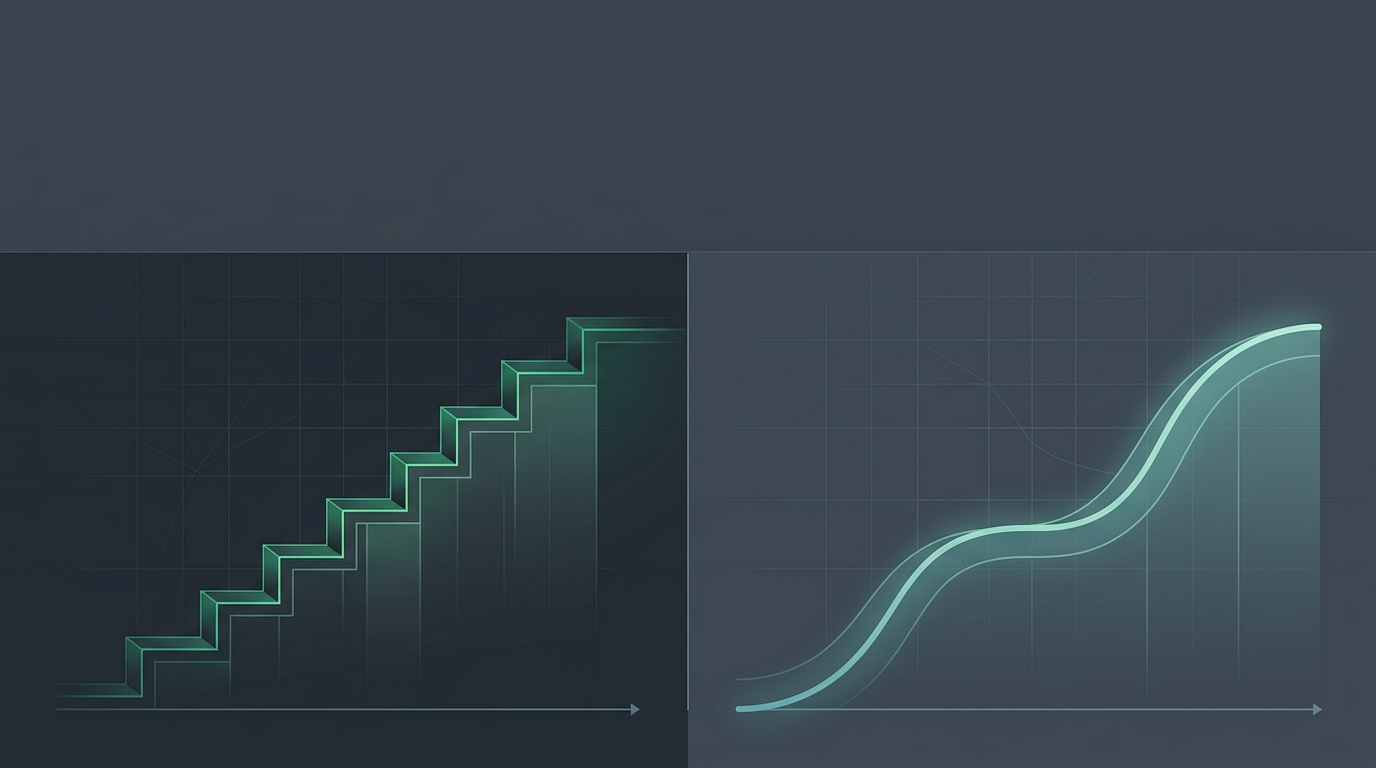
Anki를 사용해 봤다면, 당신은 SM-2에 의해 일정이 짜인 것입니다. "최적화된 일정 관리"를 갖춘 더 새로운 시스템을 사용해 봤다면, FSRS를 접했을 수도 있습니다. 두 알고리즘 모두 같은 목적 — 각 플래시카드를 다음에 언제 보여줄지 결정하는 것 — 을 수행하지만, 그 방식은 근본적으로 다릅니다. 그 차이는 대부분의 학습자가 인식하는 것보다 더 중요합니다. 당신의 일정 관리 알고리즘이 복습에 얼마나 많은 시간을 쓰는지, 실제로 자료를 얼마나 잘 유지하는지, 그리고 당신의 기억이 예상치 못하게 작동할 때 시스템이 어떻게 반응하는지를 결정하기 때문입니다. 이용 가능한 모든 간격 반복 선택지에 대한 맥락을 보려면 간격 반복 가이드 모음을 둘러보세요.
SM-2: 고전적 휴리스틱
SM-2는 1980년대에 Piotr Wozniak이 SuperMemo를 위해 개발했으며, Anki가 만들어진 이래로 줄곧 기본 일정 관리 알고리즘이었습니다. 그 설계는 시대의 제약을 반영합니다. 초기 개인용 컴퓨터에서 실행될 만큼 단순해야 했고, 사용자가 수동으로 이해할 수 있을 만큼 설명 가능해야 했습니다.
SM-2는 대략 다음과 같이 작동합니다. 각 카드는 ease factor — 기본값(일반적으로 2.5)에서 시작하여 당신의 평가에 따라 조정되는 배수 — 를 지닙니다. 초기 두 단계의 학습(고정된 짧은 간격을 사용)이 끝난 후, 다음 간격은 이전 간격에 ease factor를 곱하여 계산됩니다. 카드를 Hard로 평가하면 ease factor가 감소하여 향후 간격이 짧아집니다. Easy로 평가하면 약간 증가하여 간격이 늘어납니다. 반복적으로 어려움을 겪는 카드는 점차 낮은 ease factor를 축적하여 더 자주 복습되고, 꾸준히 맞추는 카드는 미래로 더 멀리 밀려납니다.
이 설계는 충분히 유용할 만큼 잘 작동합니다. 수백만 명의 학습자가 SM-2를 사용해 상당한 지식을 쌓았습니다. 하지만 대규모로 학습하거나 기저 가정을 분석할 때 드러나는 구조적 한계가 있습니다.
SM-2의 주요 한계
- Ease factor 표류. 일단 ease factor가 — Hard나 Again 평가를 통해 — 감소하면, 낮은 상태로 머무는 경향이 있습니다. 학습자가 명백히 자료를 내면화한 후에도 카드가 짧은 간격에 "갇힐" 수 있어, 안정적인 기억을 과도하게 복습하게 됩니다.
- 명시적 망각 모델 없음. SM-2는 당신이 언제 잊어버릴지 예측하지 않습니다. 이전 간격에 휴리스틱 배수를 적용할 뿐입니다. 그 결과로 나오는 일정은 특정 카드와 학습자의 실제 기억 감소와 맞을 수도, 맞지 않을 수도 있습니다.
- 균일한 감소 가정. 알고리즘은 모든 카드가 비슷한 속도로 감소한다고 가정하며, 오직 ease factor로만 조정합니다. 과거 복습의 이력과 패턴에서 비롯되는 서로 다른 안정성 수준이라는 개념이 없습니다.
- 콜드 스타트 경직성. 모든 새 카드는 유사한 내용이 과거에 어떻게 처리되었는지와 관계없이 같은 기본 ease factor로 시작합니다. 시스템은 카드 전반에 걸친 당신의 패턴을 학습하지 않습니다.
FSRS: 휴리스틱이 아닌 기억 모델
FSRS — Free Spaced Repetition Scheduler — 는 다른 출발점을 택합니다. 간격이 어떻게 변해야 하는지에 대한 규칙을 정의하는 대신, 기억 자체에 대한 수학적 모델을 구축하고 그 모델로부터 간격을 도출합니다. 이 알고리즘은 오픈 소스이며 동료 심사를 거쳤습니다. 기술 사양은 FSRS 오픈 소스 저장소를 참고하세요.
FSRS의 작동 원리에서 더 자세히 설명하듯이, 모델은 각 카드에 대해 세 가지 수치를 추적합니다. 난이도(이 학습자에게 갖는 본질적 어려움), 안정성(기억이 얼마나 느리게 감소하는지), 인출 가능성(현재 시점에서 성공적으로 회상할 확률)입니다. 다음 복습은 인출 가능성이 목표 임계값 — 흔히 90% — 에 도달할 것으로 예측되는 시점으로 일정이 잡힙니다.
모델이 회상 확률에 대해 명시적인 예측을 하기 때문에, 기억이 진정으로 안정적일 때는 긴 간격을, 취약할 때는 짧은 간격을 설정할 수 있습니다. SM-2는 ease factor 메커니즘을 통해 이러한 결정을 근사하는 것밖에 할 수 없습니다.
정면 비교
| 속성 | SM-2 | FSRS |
|---|---|---|
| 핵심 메커니즘 | 이전 간격에 적용되는 ease factor 휴리스틱 | 시간에 따른 인출 가능성을 예측하는 기억 모델 |
| 간격 도출 | 이전 간격 × ease factor | 인출 가능성이 목표 임계값으로 떨어질 때까지의 시간 |
| 기억 유지 목표 설정 | 암묵적 — 명시적 기억 유지 확률 없음 | 명시적 — 설정 가능한 목표(예: 90%) |
| 학습자별 적응 | 카드별 ease factor 조정만 가능 | 모델 가중치를 개별 복습 기록에 맞게 적합화 가능 |
| Ease factor 표류 | 있음 — 낮은 ease factor가 지속되는 경향 | 해당 없음 — 안정성이 ease factor를 대체 |
| 사용되는 평가 신호 | ease factor와 간격 배수를 조정 | 안정성과 난이도를 갱신; 간격을 다시 도출 |
| 투명성 | 단순한 규칙, 수동으로 설명하기 쉬움 | 더 복잡한 모델이지만 명시적인 기억 유지 예측 |
| 복습 효율 | 대부분의 사용 사례에 좋음 | 동등한 기억 유지를 위해 일반적으로 더 적은 복습 |
알고리즘이 복습 효율에 영향을 미치는 이유
두 알고리즘 간의 복습 효율 차이는 각각이 당신의 기억 상태를 얼마나 잘 추적하는지로 귀결됩니다. SM-2는 대용물 — ease factor와 과거 복습에 걸친 그것의 축적 — 을 사용하는데, 이는 기억 안정성과 상관관계가 있긴 하지만 그것을 직접 측정하지는 않습니다. 그 결과 평균적으로는 합리적이지만 개별 카드에 대해서는 부정확한 일정이 나옵니다.
FSRS는 안정성을 명시적으로 추적함으로써, SM-2가 유사하게 다루는 두 가지 상황을 구별할 수 있습니다. 일련의 Good 복습을 통해 최근에 응고화된, ease factor가 낮은 카드와, 여전히 진정으로 취약한, ease factor가 낮은 카드입니다. SM-2는 둘 다에게 대략 같은 짧은 간격을 줍니다. FSRS는 응고화된 카드의 안정성이 증가했으므로 더 긴 간격을 줍니다.
여러 달에 걸쳐 학습하는 큰 덱에서는 이 정밀함이 복리처럼 쌓입니다. 안정적인 기억은 불필요하게 복습되지 않고, 취약한 기억은 기억 유지 임계값 아래로 떨어지기 전에 복습됩니다. 순효과는 더 작고 더 잘 겨냥된 복습 대기열이며, 이는 같은 — 또는 더 높은 — 실제 기억 유지를 유지하면서 복습에 더 적은 시간을 쓴다는 것을 의미합니다.
장단점과 실용적 고려 사항
SM-2에도 장점이 없는 것은 아닙니다. 극도로 투명합니다. 몇 줄로 알고리즘을 읽을 수 있고 다음에 무엇을 할지 정확히 이해할 수 있습니다. 수십 년에 걸친 실제 검증이 있습니다. 그리고 작은 덱이나 짧은 학습 기간을 가진 학습자에게는 SM-2와 FSRS 간의 효율 차이가 실제로는 무시할 만할 수 있습니다.
FSRS는 더 많은 복잡성을 도입합니다. 모델에는 합리적인 기본값이 — 그리고 이상적으로는 당신의 데이터에 대한 보정이 — 필요한 매개변수가 있습니다. 일관된 평가 규율을 요구하는데, 부정확한 평가가 휴리스틱보다 모델을 더 많이 오도하기 때문입니다. 카드를 부주의하게 평가하거나 합격/불합격의 이진 방식을 사용하는 학습자에게는 FSRS의 이점이 상당히 줄어듭니다.
또 다른 중요한 고려 사항은 각 시스템에서 "기억 유지"가 무엇을 의미하는가입니다. SM-2는 설정할 기억 유지 목표를 주지 않습니다. 그 결과로 나오는 기억 유지는 기본 ease factor와 카드를 평가하는 방식에 달려 있습니다. FSRS는 목표를 명시적으로 — 70%, 90%, 95% — 선택하게 하고, 이를 유지하도록 간격을 조정합니다. 높은 목표는 짧은 간격과 더 많은 복습을 의미하고, 낮은 목표는 긴 간격과 더 많은 망각을 의미합니다. 이 절충에 대한 명시적 통제권을 갖는 것은, 전문 자격증 대 가벼운 어학 학습처럼 회상이 얼마나 신뢰할 만해야 하는지에 대해 확고한 견해가 있을 때 유용합니다.
둘 중 선택하기
새로 시작하는데 당신의 학습 시스템이 FSRS를 지원한다면, SM-2를 사용할 이유는 거의 없습니다. 모델 기반 접근 방식은 더 정확하고, 더 적응적이며, 대규모에서 더 나은 결과를 만들어냅니다. 사용자가 겪는 학습 곡선은 미미합니다. 카드는 여전히 같은 방식으로 평가하고, 알고리즘이 그 평가를 더 지능적으로 사용할 뿐입니다.
수년간의 복습 기록을 가진 기존 SM-2 덱이 있다면, FSRS로의 마이그레이션은 도구에 따라 간단할 수도 아닐 수도 있습니다. 어떤 시스템은 SM-2 기록으로부터 FSRS 안정성을 추정할 수 있고, 다른 시스템은 새로 시작합니다. 결정하기 전에 마이그레이션 경로를 확인해 볼 가치가 있습니다.
장기적 실천으로서 능동 회상에 진지한 누구에게나, 덱이 커질수록 알고리즘은 점점 더 중요해집니다. 가볍게 복습하는 수백 장의 카드로는 그 차이가 드러나지 않을 수 있습니다. 수년에 걸쳐 학습하는 수만 장의 카드에서는 모든 효율 향상이 의미 있게 복리로 쌓입니다.
가장 좋은 일정 관리 알고리즘은 당신이 실제로 꾸준히 사용할 알고리즘입니다. 하지만 동등한 헌신이 주어진다면, FSRS는 더 정확한 일정, 더 명시적인 기억 유지 통제, 그리고 대규모에서 더 나은 효율을 만들어냅니다.
일정 관리 알고리즘과 더 넓은 학습 루프
일정 관리는 학습 시스템의 한 구성 요소일 뿐, 그 전부가 아니라는 점을 기억할 가치가 있습니다. 복습하는 플래시카드의 품질, 초기 읽기 동안의 관여도, 각 회상 시도에 가져오는 이해의 깊이 — 이러한 요인들이 일정 관리 알고리즘과 상호 작용하여 실제 학습 결과를 결정합니다. 완벽하게 일정이 짜인 평범한 카드는 여전히 평범한 카드입니다.
FSRS의 가치는 일정 관리라는 병목을 제거한다는 데 있습니다. 알고리즘이 당신의 기억을 정확히 모델링하고 간격을 적절히 설정하고 나면, 남은 변수들은 당신의 통제 안에 있습니다. 어떻게 읽는지, 어떻게 카드를 생성하는지, 얼마나 정직하게 평가하는지, 그리고 얼마나 꾸준히 복습에 임하는지입니다.
LearnBook은 전반에 걸쳐 FSRS를 사용합니다. 그래서 여러 출처의 자료를 한꺼번에 복습할 때, 책 간 대기열의 모든 카드는 공유된 일정에 강제로 맞춰지는 대신 각자 독립적으로 보정된 간격을 지닙니다. 전체 학습 워크플로 안에서 FSRS가 실제로 작동하는 모습을 보려면 플래시카드와 퀴즈가 어떻게 생성되고 일정이 짜이는지를 읽어 보세요.
공유
Related Posts
간격 반복과 FSRS
FSRS는 각 카드를 언제 잊을지 예측해 그에 맞춰 복습을 배치합니다. LearnBook 복습을 떠받치는 모델을 명확하게 살펴봅니다.
2026-06-18T15:28:15+08:00
간격 반복과 FSRS
간격 반복은 잊기 직전의 시점에, 점점 길어지는 간격으로 복습을 배치합니다. 그 원리와 효과적인 이유를 설명합니다.
2026-06-18T15:28:15+08:00