Loading page
间隔重复与 FSRS发布于
FSRS 对比 SM-2:调度算法为何如此重要
如果你用过 Anki,那么你一直在由 SM-2 进行调度。如果你用过带有"优化调度"功能的较新系统,你可能已经接触过 FSRS。这两种算法服务于相同的目的——决定下一次何时向你展示每张闪卡——但它们的实现方式在根本上截然不同。这一差异比大多数学习者意识到的更为重要,因为你的调度算法决定了你花多少时间复习、你实际能保留多少材料,以及当你的记忆表现出乎意料时系统如何响应。关于所有间隔重复选项的背景介绍,请浏览间隔重复指南合集。
SM-2:经典的启发式算法
SM-2 由 Piotr Wozniak 在 1980 年代为 SuperMemo 开发,并自 Anki 诞生以来一直是其默认调度算法。其设计反映了那个时代的约束:它需要简单到能在早期个人电脑上运行,并且透明到用户可以手动理解其逻辑。
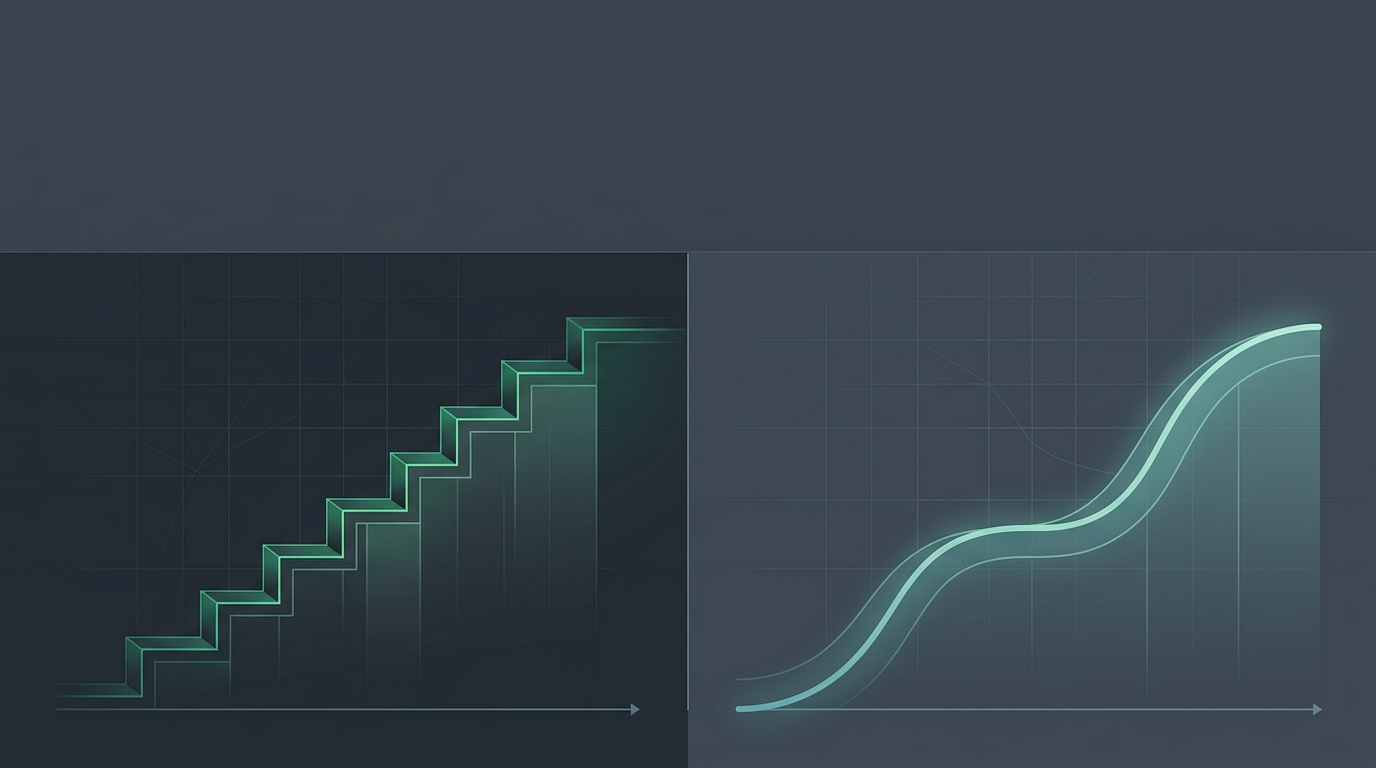
SM-2 的工作原理大致如下:每张卡片带有一个易度因子——一个从默认值(通常为 2.5)开始并根据你的评分进行调整的乘数。在最初两个学习步骤(使用固定的短间隔)之后,下一个间隔通过将上一个间隔乘以易度因子来计算。如果你把一张卡评为"困难",易度因子会降低,从而缩短未来的间隔;如果评为"容易",则略微提高,延长间隔。你反复感到费力的卡片会逐渐积累较低的易度因子并被更频繁地复习;你一直能轻松答对的卡片则会被推得更远。
这种设计足够好用,是真正有价值的——数百万学习者已经用 SM-2 建立了大量知识。但当你大规模学习或分析其底层假设时,其结构性局限就会显现出来。
SM-2 的主要局限
- 易度因子漂移。一旦易度因子降低——通过"困难"或"又一次"评分——它往往会保持在低位。即使在学习者已明显内化材料之后,卡片仍可能被"困"在短间隔中,导致对稳定记忆的过度复习。
- 没有明确的遗忘模型。SM-2 不预测你何时会遗忘;它对上一个间隔应用一个启发式乘数。对于给定的卡片和学习者,所产生的调度可能与实际的记忆衰减对齐,也可能并不对齐。
- 均匀衰减假设。该算法假设所有卡片的衰减速度相似,仅通过易度因子进行调整。它没有过往复习历史和模式所产生的不同稳定性水平的概念。
- 冷启动僵化。每张新卡片都以相同的默认易度因子开始,不考虑过去类似内容的处理情况。系统不会跨卡片学习你的模式。
FSRS:记忆模型,而非启发式规则
FSRS(Free Spaced Repetition Scheduler,自由间隔重复调度器)采取了不同的出发点。它不是定义间隔应如何变化的规则,而是构建一个记忆本身的数学模型,并从该模型推导间隔。该算法是开源且经过同行评审的;技术规范请参见 FSRS 开源仓库。
如FSRS 工作原理中详细描述的那样,该模型为每张卡片追踪三个量:难度(对该学习者而言的内在难易程度)、稳定性(记忆衰减的速度)和可提取性(此刻成功回忆的概率)。下一次复习被安排在可提取性预计降至目标阈值的时间点——通常为 90%。
由于模型对回忆概率作出明确预测,它可以在记忆真正稳定时设置长间隔,在记忆脆弱时设置短间隔——这些决策是 SM-2 只能通过其易度因子机制粗略近似的。
正面对比
| 属性 | SM-2 | FSRS |
|---|---|---|
| 核心机制 | 对上一个间隔应用易度因子启发式规则 | 记忆模型,预测随时间变化的可提取性 |
| 间隔推导 | 上一个间隔 × 易度因子 | 可提取性降至目标阈值所需的时间 |
| 记忆保留目标 | 隐式——没有明确的记忆保留概率 | 明确——可配置目标(如 90%) |
| 个人适应性 | 仅限逐卡易度因子调整 | 模型权重可拟合至个人复习历史 |
| 易度因子漂移 | 存在——低易度因子倾向于持续 | 不适用——稳定性取代了易度因子 |
| 评分信号的使用 | 调整易度因子和间隔乘数 | 更新稳定性和难度;重新推导间隔 |
| 透明度 | 规则简单,易于手动解释 | 模型更复杂,但有明确的记忆保留预测 |
| 复习效率 | 适用于大多数使用场景 | 在相同记忆保留水平下通常复习次数更少 |
算法为何影响复习效率
两种算法之间的复习效率差异,归根结底在于各自追踪你记忆实际状态的精确程度。SM-2 使用一个代理——易度因子及其在过往复习中的积累——它与记忆稳定性相关,但并不直接衡量它。结果是一个平均而言合理但对个别卡片不够精确的调度。
FSRS 通过明确追踪稳定性,能够区分两种 SM-2 会相同对待的情况:一张易度因子较低但你最近通过一系列"良好"评分已经巩固的卡片,以及一张易度因子较低且真正依然脆弱的卡片。SM-2 会给这两张卡片大致相同的短间隔;FSRS 则会给前者更长的间隔,因为其稳定性已经增长。
在数月时间里研究一个大型卡组,这种精确度会形成复利效应。稳定的记忆不会被不必要地复习;脆弱的记忆会在降至保留阈值之前得到复习。净效果是一个更小、更精准的复习队列,这意味着在维持相同——甚至更高——实际记忆保留水平的同时,花费更少的复习时间。
权衡与实际考量
SM-2 并非没有优势。它极为透明:你可以用几行代码读懂该算法,准确理解它下一步会做什么。它有数十年的真实世界验证。对于卡组较小或学习周期较短的学习者,SM-2 和 FSRS 之间的效率差异在实践中可能微不足道。
FSRS 引入了更多复杂性。模型有需要合理默认值的参数——理想情况下还需要根据你的数据进行校准。它需要一致的评分纪律,因为不准确的评分对模型的误导程度大于对启发式规则的误导程度。对于漫不经心地评分或使用简单通过/失败方式的学习者,FSRS 的优势会显著减弱。
另一个重要考量是两个系统中"记忆保留"的含义。SM-2 不给你一个可以设置的保留目标;最终的保留率取决于默认易度因子和你的评分方式。FSRS 让你明确选择目标——70%、90%、95%——并调整间隔来维持它。目标越高意味着间隔越短、复习次数越多;目标越低意味着间隔越长、遗忘率越高。当你对回忆需要达到的可靠程度有强烈偏好时,例如专业认证考试与休闲语言学习,对这一权衡拥有明确的控制权是非常有用的。
如何在两者之间选择
如果你是从头开始,且你的学习系统支持 FSRS,几乎没有理由使用 SM-2。基于模型的方法更准确、更具适应性,并且在大规模使用时能产生更好的结果。对用户而言,学习曲线极低——你仍然以相同的方式对卡片评分;算法只是更智能地使用这些评分。
如果你有一个积累了多年复习历史的 SM-2 卡组,迁移到 FSRS 是否顺畅取决于你使用的工具。有些系统能从 SM-2 历史估算 FSRS 稳定性;有些则从零开始。在做决定之前,值得先了解迁移路径。
对于任何将主动回忆视为长期实践的认真学习者,随着卡组的增长,算法变得越来越重要。几百张随意复习的卡片可能体现不出差异;数万张卡片经过多年学习,每一点效率提升都会形成有意义的复利积累。
最好的调度算法是你会真正坚持使用的那一个。但在同等投入的前提下,FSRS 能产生更准确的调度、更明确的记忆保留控制,以及在大规模使用时更高的效率。
调度算法与更广泛的学习闭环
值得记住的是,调度是学习系统的一个组成部分,而非全部。你正在复习的闪卡质量、你在初始阅读时的参与程度、你在每次回忆尝试中所带入的理解深度——这些因素与调度算法共同作用,决定实际的学习成果。一张平庸的卡片即便被完美调度,仍然是一张平庸的卡片。
FSRS 的价值在于消除了调度瓶颈。一旦算法准确建模了你的记忆并恰当地设置了间隔,剩余的变量就在你的掌控之中:你如何阅读、如何生成卡片、如何诚实评分,以及你能多持续地参加复习。
LearnBook 全程使用 FSRS——因此当你同时复习多个来源的材料时,跨书队列中的每张卡片都带有其独立校准的间隔,而不是被强制纳入一个共享的调度。要在完整学习工作流程中亲身体验 FSRS,请阅读闪卡和测验是如何生成与调度的。
分享
相关文章
间隔重复与 FSRS
FSRS 预测你何时会忘记每张卡片,并据此安排复习。这是对 LearnBook 复习系统背后算法模型的清晰解析。
2026-06-18T14:26:00+08:00