Loading page
Spaced repetition och FSRSpublicerad
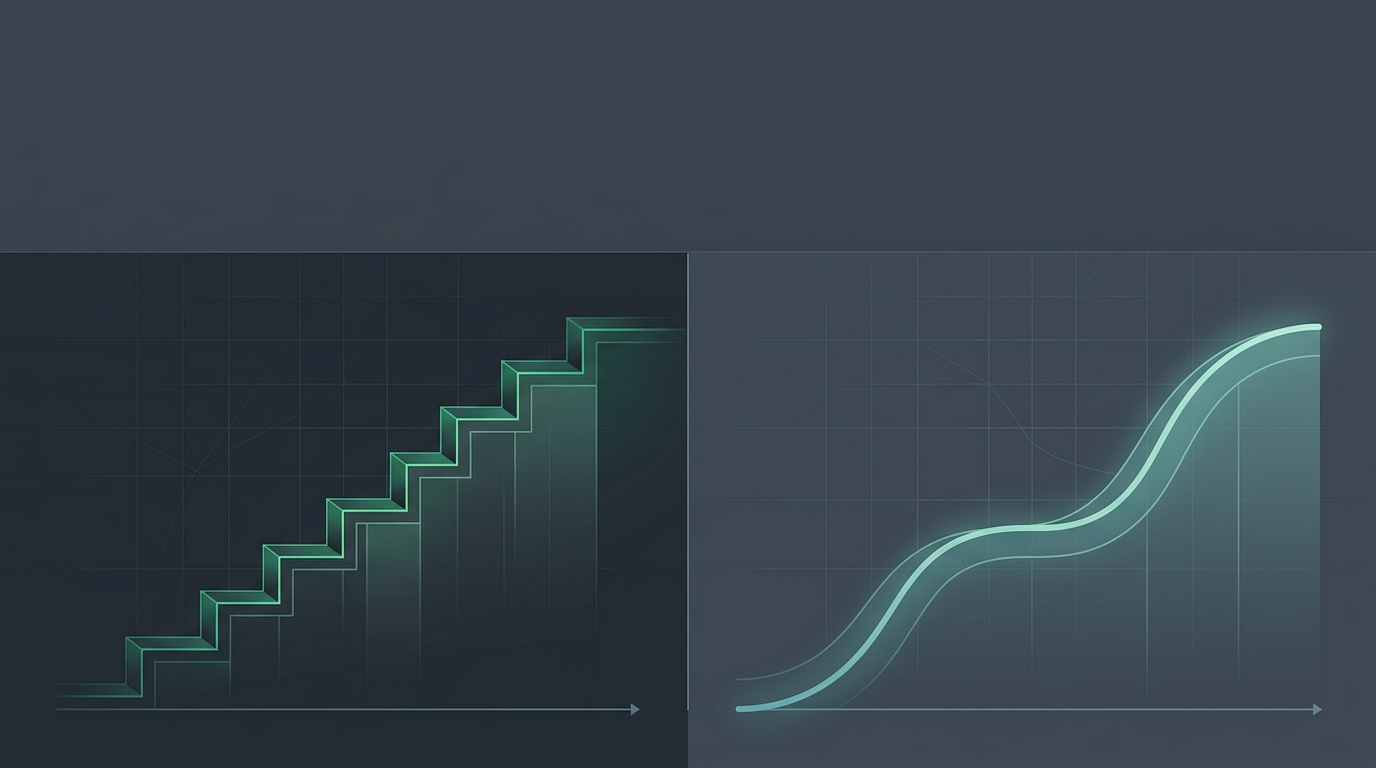
FSRS vs SM-2: Varför din schemaläggningsalgoritm spelar roll
Om du har använt Anki har du schemalagts av SM-2. Om du har använt ett nyare system med "optimerad schemaläggning" kan du ha stött på FSRS. Båda algoritmerna tjänar samma syfte — att avgöra när varje flashkort ska visas för dig härnäst — men de gör det på fundamentalt olika sätt. Skillnaden spelar större roll än de flesta inlärare inser, eftersom din schemaläggningsalgoritm avgör hur mycket tid du lägger på repetition, hur väl du faktiskt behåller materialet och hur systemet reagerar när ditt minne beter sig oväntat. För en överblick över alla tillgängliga alternativ för spridd repetition, bläddra i guidesamlingen om spridd repetition.
SM-2: Den klassiska heuristiken
SM-2 utvecklades av Piotr Wozniak på 1980-talet för SuperMemo och har varit standardalgoritmen för schemaläggning i Anki sedan dess tillkomst. Dess design speglar tidens begränsningar: den behövde vara enkel nog att köra på tidiga persondatorer och tillräckligt begriplig för att användare skulle kunna förstå den manuellt.
SM-2 fungerar ungefär så här. Varje kort bär en lätthetsfaktor — en multiplikator som börjar på ett standardvärde (vanligtvis 2,5) och justeras utifrån dina betyg. Efter de två inledande inlärningsstegen (som använder fasta korta intervall) beräknas nästa intervall genom att multiplicera det föregående intervallet med lätthetsfaktorn. Om du betygsätter ett kort som Hard minskar lätthetsfaktorn, vilket förkortar framtida intervall. Om du betygsätter det som Easy ökar den något, vilket förlänger dem. Ett kort du upprepade gånger kämpar med ackumulerar gradvis en låg lätthetsfaktor och repeteras oftare; ett kort du konsekvent klarar skjuts längre in i framtiden.
Denna design fungerar tillräckligt väl för att vara genuint användbar — miljontals inlärare har byggt betydande kunskap med SM-2. Men den har strukturella begränsningar som blir tydliga när du studerar i stor skala eller analyserar de underliggande antagandena.
SM-2:s viktigaste begränsningar
- Drift i lätthetsfaktorn. När en lätthetsfaktor väl har minskat — genom Hard- eller Again-betyg — tenderar den att förbli låg. Kort kan fastna i korta intervall även efter att inläraren tydligt har internaliserat materialet, vilket leder till överrepetition av stabila minnen.
- Ingen explicit glömskemodell. SM-2 förutsäger inte när du kommer att glömma; den tillämpar en heuristisk multiplikator på det föregående intervallet. Det resulterande schemat kan stämma eller inte stämma med det faktiska minnesförfallet för ett givet kort och en given inlärare.
- Antagande om enhetligt förfall. Algoritmen antar att alla kort förfaller i liknande takt, justerat endast av lätthetsfaktorn. Den har inget begrepp om olika stabilitetsnivåer som uppstår ur historiken och mönstret hos tidigare repetitioner.
- Stelhet vid kallstart. Varje nytt kort börjar med samma standardlätthetsfaktor oavsett hur liknande innehåll har hanterats tidigare. Systemet lär sig inte dina mönster över kort.
FSRS: En minnesmodell, inte en heuristik
FSRS — Free Spaced Repetition Scheduler — utgår från en annan startpunkt. I stället för att definiera regler för hur intervall ska förändras bygger den en matematisk modell av minnet självt och härleder intervall från den modellen. Algoritmen är öppen källkod och granskad av kollegor; se FSRS öppna källkodsförråd för den tekniska specifikationen.
Som beskrivs mer detaljerat i Hur FSRS fungerar spårar modellen tre storheter för varje kort: svårighet (inneboende svårighetsgrad för denna inlärare), stabilitet (hur långsamt minnet förfaller) och återhämtbarhet (sannolikheten för lyckad återhämtning i detta ögonblick). Nästa repetition schemaläggs till den tidpunkt då återhämtbarheten förutsägs nå en måltröskel — vanligen 90 %.
Eftersom modellen gör explicita förutsägelser om sannolikheten att minnas kan den sätta intervall som är långa när minnet är genuint stabilt och korta när det är skört — beslut som SM-2 endast kan approximera genom sin lätthetsfaktormekanism.
Jämförelse sida vid sida
| Egenskap | SM-2 | FSRS |
|---|---|---|
| Kärnmekanism | Heuristik med lätthetsfaktor tillämpad på det föregående intervallet | Minnesmodell som förutsäger återhämtbarhet över tid |
| Härledning av intervall | Föregående intervall × lätthetsfaktor | Tid tills återhämtbarheten sjunker till måltröskeln |
| Inriktning på kvarhållning | Implicit — ingen explicit kvarhållningssannolikhet | Explicit — konfigurerbart mål (t.ex. 90 %) |
| Anpassning per inlärare | Endast justeringar av lätthetsfaktor per kort | Modellvikter kan anpassas till individuell repetitionshistorik |
| Drift i lätthetsfaktorn | Ja — låga lätthetsfaktorer tenderar att bestå | Ej tillämpligt — stabilitet ersätter lätthetsfaktor |
| Använd betygssignal | Justerar lätthetsfaktor och intervallmultiplikator | Uppdaterar stabilitet och svårighet; härleder intervall på nytt |
| Transparens | Enkla regler, lätta att förklara manuellt | Mer komplex modell, men explicita kvarhållningsförutsägelser |
| Repetitionseffektivitet | Bra för de flesta användningsfall | Generellt färre repetitioner för likvärdig kvarhållning |
Varför algoritmen påverkar repetitionseffektiviteten
Skillnaden i repetitionseffektivitet mellan de två algoritmerna handlar om hur väl var och en spårar det faktiska tillståndet hos ditt minne. SM-2 använder en proxy — lätthetsfaktorn och dess ackumulering över tidigare repetitioner — som korrelerar med minnesstabilitet men inte mäter den direkt. Resultatet är ett schema som är rimligt i genomsnitt men oprecist för enskilda kort.
FSRS kan, genom att spåra stabiliteten explicit, skilja mellan två situationer som SM-2 behandlar likadant: ett kort med en låg lätthetsfaktor som du nyligen har konsoliderat genom en följd av Good-repetitioner, och ett kort med en låg lätthetsfaktor som förblir genuint skört. SM-2 ger båda ungefär samma korta intervall; FSRS ger det konsoliderade kortet ett längre intervall eftersom dess stabilitet har vuxit.
Över en stor kortlek som studeras i månader förstärks denna precision. Stabila minnen repeteras inte i onödan; sköra minnen repeteras innan de faller under kvarhållningströskeln. Nettoeffekten är en repetitionskö som är mindre och bättre riktad, vilket innebär mindre tid på repetition samtidigt som samma — eller högre — faktiska kvarhållning bibehålls.
Avvägningar och praktiska överväganden
SM-2 är inte utan fördelar. Den är extremt transparent: du kan läsa algoritmen på några rader och förstå exakt vad den kommer att göra härnäst. Den har decennier av validering i verkligheten. Och för inlärare med små kortlekar eller korta studietidslinjer kan effektivitetsskillnaden mellan SM-2 och FSRS i praktiken vara försumbar.
FSRS introducerar mer komplexitet. Modellen har parametrar som behöver vettiga standardvärden — och helst kalibrering mot dina data. Den kräver en konsekvent betygsättningsdisciplin, eftersom felaktiga betyg vilseleder en modell mer än de vilseleder en heuristik. För en inlärare som betygsätter kort slarvigt eller använder ett binärt godkänt/underkänt-tillvägagångssätt krymper FSRS fördel betydligt.
Det andra viktiga övervägandet är vad "kvarhållning" betyder i respektive system. SM-2 ger dig inget kvarhållningsmål att ställa in; den resulterande kvarhållningen beror på standardlätthetsfaktorn och hur du betygsätter kort. FSRS låter dig välja ditt mål explicit — 70 %, 90 %, 95 % — och justerar intervallen för att upprätthålla det. Högre mål innebär kortare intervall och fler repetitioner; lägre mål innebär längre intervall och mer glömska. Att ha explicit kontroll över denna avvägning är användbart när du har starka åsikter om hur tillförlitlig din återhämtning behöver vara, till exempel för en yrkescertifiering jämfört med ledig språkinlärning.
Att välja mellan dem
Om du börjar från grunden och ditt studiesystem stöder FSRS finns det få skäl att använda SM-2. Det modellbaserade angreppssättet är mer träffsäkert, mer anpassningsbart och ger bättre resultat i stor skala. Inlärningskurvan för användaren är minimal — du betygsätter fortfarande kort på samma sätt; algoritmen använder bara dessa betyg mer intelligent.
Om du har en befintlig SM-2-kortlek med flera års repetitionshistorik kan en migrering till FSRS vara mer eller mindre enkel beroende på ditt verktyg. Vissa system kan uppskatta FSRS-stabilitet från SM-2-historik; andra börjar från grunden. Det är värt att kontrollera migreringsvägen innan du bestämmer dig.
För alla som tar aktiv återhämtning på allvar som en långsiktig praktik spelar algoritmen allt större roll i takt med att kortleken växer. Några hundra kort som repeteras ledigt avslöjar kanske inte skillnaden; tiotusentals kort som studeras under år får varje effektivitetsvinst att förstärkas på ett meningsfullt sätt.
Den bästa schemaläggningsalgoritmen är den du faktiskt kommer att använda konsekvent. Men givet lika stort engagemang producerar FSRS mer träffsäkra scheman, mer explicit kontroll över kvarhållning och bättre effektivitet i stor skala.
Schemaläggningsalgoritmer och den bredare inlärningsloopen
Det är värt att komma ihåg att schemaläggning är en komponent i ett inlärningssystem, inte hela det. Kvaliteten på de flashkort du repeterar, ditt engagemang under den inledande läsningen, djupet i den förståelse du tar med dig till varje återhämtningsförsök — dessa faktorer samverkar med schemaläggningsalgoritmen för att avgöra de faktiska inlärningsresultaten. Ett medelmåttigt kort som schemaläggs perfekt är fortfarande ett medelmåttigt kort.
Värdet av FSRS är att den avlägsnar flaskhalsen i schemaläggningen. När algoritmen väl modellerar ditt minne träffsäkert och sätter intervall lämpligt ligger de återstående variablerna under din kontroll: hur du läser, hur du skapar kort, hur ärligt du betygsätter och hur konsekvent du dyker upp för repetitioner.
LearnBook använder FSRS genomgående — så när du repeterar material från flera källor samtidigt bär varje kort i kön över böcker sitt eget självständigt kalibrerade intervall i stället för att tvingas in i ett gemensamt schema. För att se FSRS i praktiken inom hela studieflödet, läs om hur flashkort och frågesporter genereras och schemaläggs.
Dela
Related Posts
Spaced repetition och FSRS
FSRS förutsäger när du kommer att glömma varje kort och schemalägger repetitioner därefter. En tydlig titt på modellen bakom LearnBooks repetitioner.
2026-06-18T16:11:38+08:00
Spaced repetition och FSRS
Spaced repetition schemalägger repetitioner med ökande intervall, precis innan du skulle glömma. Så här fungerar det och varför det är så effektivt.
2026-06-18T16:11:38+08:00