Loading page
Powtórki rozłożone w czasie i FSRSopublikowano
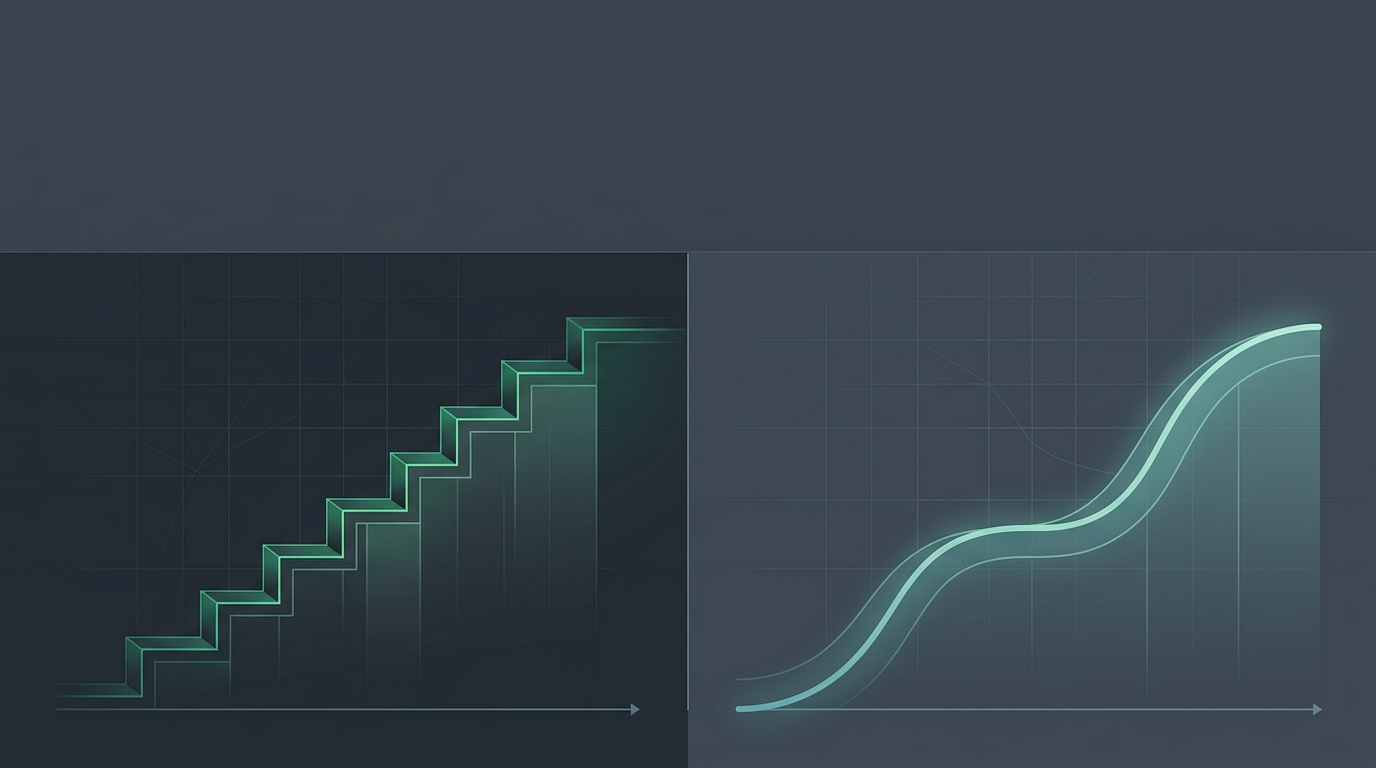
FSRS kontra SM-2: dlaczego Twój algorytm planowania ma znaczenie
Jeśli korzystałeś z Anki, to Twoje powtórki harmonogramował SM-2. Jeśli korzystałeś z nowszego systemu z „zoptymalizowanym harmonogramowaniem”, mogłeś zetknąć się z FSRS. Oba algorytmy służą temu samemu celowi — decydowaniu, kiedy pokazać Ci kolejną fiszkę — ale robią to w zasadniczo różny sposób. Ta różnica ma większe znaczenie, niż większość uczących się sądzi, ponieważ Twój algorytm harmonogramowania określa, ile czasu spędzasz na powtórkach, jak dobrze naprawdę zapamiętujesz materiał i jak system reaguje, gdy Twoja pamięć zachowuje się nieoczekiwanie. Aby zapoznać się z kontekstem wszystkich dostępnych opcji powtórek interwałowych, przejrzyj zbiór przewodników powtórki interwałowe.
SM-2: klasyczna heurystyka
SM-2 został opracowany przez Piotra Woźniaka w latach 80. dla SuperMemo i od początku istnienia Anki jest w nim domyślnym algorytmem harmonogramowania. Jego konstrukcja odzwierciedla ograniczenia epoki: musiał być na tyle prosty, by działać na wczesnych komputerach osobistych, i na tyle zrozumiały, by użytkownicy mogli go pojąć ręcznie.
SM-2 działa z grubsza następująco. Każda karta nosi współczynnik łatwości — mnożnik, który zaczyna się od wartości domyślnej (zwykle 2,5) i dostosowuje się na podstawie Twoich ocen. Po dwóch początkowych krokach nauki (które wykorzystują stałe krótkie interwały) następny interwał jest obliczany przez pomnożenie poprzedniego interwału przez współczynnik łatwości. Jeśli ocenisz kartę jako Hard, współczynnik łatwości maleje, skracając przyszłe interwały. Jeśli ocenisz ją jako Easy, nieznacznie rośnie, wydłużając je. Karta, z którą wciąż się zmagasz, stopniowo gromadzi niski współczynnik łatwości i jest powtarzana częściej; karta, którą konsekwentnie opanowujesz bezbłędnie, jest przesuwana dalej w przyszłość.
Ta konstrukcja działa wystarczająco dobrze, by być naprawdę użyteczną — miliony uczących się zbudowały solidną wiedzę za pomocą SM-2. Ma jednak ograniczenia strukturalne, które uwidaczniają się, gdy uczysz się na dużą skalę lub analizujesz leżące u podstaw założenia.
Kluczowe ograniczenia SM-2
- Dryf współczynnika łatwości. Gdy współczynnik łatwości spadnie — przez oceny Hard lub Again — ma tendencję do pozostawania niski. Karty mogą „uwięznąć” w krótkich interwałach nawet po tym, jak uczący się wyraźnie zinternalizował materiał, co prowadzi do nadmiernego powtarzania stabilnych wspomnień.
- Brak jawnego modelu zapominania. SM-2 nie przewiduje, kiedy zapomnisz; stosuje heurystyczny mnożnik do poprzedniego interwału. Powstający harmonogram może, ale nie musi, pokrywać się z rzeczywistym zanikiem pamięci dla danej karty i uczącego się.
- Założenie jednorodnego zaniku. Algorytm zakłada, że wszystkie karty zanikają w podobnym tempie, korygowanym jedynie współczynnikiem łatwości. Nie ma pojęcia różnych poziomów stabilności wynikających z historii i wzorca przeszłych powtórek.
- Sztywność zimnego startu. Każda nowa karta zaczyna od tego samego domyślnego współczynnika łatwości, niezależnie od tego, jak podobne treści były obsługiwane w przeszłości. System nie uczy się Twoich wzorców między kartami.
FSRS: model pamięci, a nie heurystyka
FSRS — Free Spaced Repetition Scheduler — obiera inny punkt wyjścia. Zamiast definiować reguły tego, jak powinny zmieniać się interwały, buduje matematyczny model samej pamięci i wyprowadza interwały z tego modelu. Algorytm jest open source i recenzowany; specyfikację techniczną znajdziesz w otwartym repozytorium FSRS.
Jak szczegółowiej opisano w artykule Jak działa FSRS, model śledzi trzy wielkości dla każdej karty: trudność (wewnętrzną trudność dla danego uczącego się), stabilność (jak wolno zanika pamięć) oraz odtwarzalność (prawdopodobieństwo udanego przypomnienia w danej chwili). Kolejna powtórka jest planowana na moment, w którym przewiduje się, że odtwarzalność osiągnie docelowy próg — zwykle 90%.
Ponieważ model formułuje jawne przewidywania dotyczące prawdopodobieństwa przypomnienia, może ustawiać długie interwały, gdy pamięć jest naprawdę stabilna, i krótkie, gdy jest krucha — decyzje, które SM-2 może jedynie przybliżać poprzez mechanizm współczynnika łatwości.
Porównanie bezpośrednie
| Cecha | SM-2 | FSRS |
|---|---|---|
| Główny mechanizm | Heurystyka współczynnika łatwości stosowana do poprzedniego interwału | Model pamięci przewidujący odtwarzalność w czasie |
| Wyprowadzanie interwału | Poprzedni interwał × współczynnik łatwości | Czas do spadku odtwarzalności do docelowego progu |
| Wyznaczanie celu zapamiętywania | Niejawne — brak jawnego prawdopodobieństwa zapamiętania | Jawne — konfigurowalny cel (np. 90%) |
| Adaptacja do uczącego się | Tylko korekty współczynnika łatwości na poziomie karty | Wagi modelu można dopasować do indywidualnej historii powtórek |
| Dryf współczynnika łatwości | Tak — niskie współczynniki łatwości mają tendencję do utrzymywania się | Nie dotyczy — stabilność zastępuje współczynnik łatwości |
| Wykorzystywany sygnał oceny | Dostosowuje współczynnik łatwości i mnożnik interwału | Aktualizuje stabilność i trudność; wyprowadza interwał na nowo |
| Przejrzystość | Proste reguły, łatwe do ręcznego wyjaśnienia | Bardziej złożony model, ale jawne przewidywania zapamiętywania |
| Efektywność powtórek | Dobra w większości zastosowań | Zwykle mniej powtórek przy równoważnym zapamiętywaniu |
Dlaczego algorytm wpływa na efektywność powtórek
Różnica w efektywności powtórek między tymi dwoma algorytmami sprowadza się do tego, jak dobrze każdy z nich śledzi rzeczywisty stan Twojej pamięci. SM-2 używa zastępczego wskaźnika — współczynnika łatwości i jego kumulacji na przestrzeni przeszłych powtórek — który koreluje ze stabilnością pamięci, ale nie mierzy jej bezpośrednio. Rezultatem jest harmonogram rozsądny przeciętnie, lecz nieprecyzyjny dla poszczególnych kart.
FSRS, śledząc stabilność jawnie, potrafi odróżnić dwie sytuacje, które SM-2 traktuje podobnie: kartę o niskim współczynniku łatwości, którą niedawno utrwaliłeś serią ocen Good, oraz kartę o niskim współczynniku łatwości, która pozostaje naprawdę krucha. SM-2 nada obu mniej więcej ten sam krótki interwał; FSRS nada utrwalonej karcie dłuższy interwał, ponieważ jej stabilność wzrosła.
W dużej talii studiowanej przez miesiące ta precyzja się kumuluje. Stabilne wspomnienia nie są powtarzane bez potrzeby; kruche wspomnienia są powtarzane, zanim spadną poniżej progu zapamiętywania. Łącznym efektem jest mniejsza i lepiej ukierunkowana kolejka powtórek, co oznacza mniej czasu na powtórki przy utrzymaniu tego samego — lub wyższego — rzeczywistego poziomu zapamiętywania.
Kompromisy i kwestie praktyczne
SM-2 nie jest pozbawiony zalet. Jest niezwykle przejrzysty: możesz przeczytać algorytm w kilku wierszach i dokładnie zrozumieć, co zrobi w następnej kolejności. Ma dekady walidacji w realnym świecie. A dla uczących się z małymi taliami lub krótkimi horyzontami nauki różnica w efektywności między SM-2 a FSRS może być w praktyce nieznaczna.
FSRS wprowadza więcej złożoności. Model ma parametry, które wymagają sensownych wartości domyślnych — a w idealnym przypadku kalibracji do Twoich danych. Wymaga konsekwentnej dyscypliny oceniania, ponieważ niedokładne oceny wprowadzają model w błąd bardziej niż heurystykę. Dla uczącego się, który ocenia karty niedbale lub stosuje binarne podejście zaliczone/niezaliczone, przewaga FSRS znacznie maleje.
Inną ważną kwestią jest to, co „zapamiętywanie” oznacza w każdym systemie. SM-2 nie daje Ci celu zapamiętywania do ustawienia; wynikowe zapamiętywanie zależy od domyślnego współczynnika łatwości i sposobu oceniania kart. FSRS pozwala wybrać cel jawnie — 70%, 90%, 95% — i dostosowuje interwały, by go utrzymać. Wyższe cele oznaczają krótsze interwały i więcej powtórek; niższe cele oznaczają dłuższe interwały i większe zapominanie. Posiadanie jawnej kontroli nad tym kompromisem jest przydatne, gdy masz wyraziste zdanie na temat tego, jak niezawodne musi być Twoje przypominanie — na przykład dla certyfikacji zawodowej w przeciwieństwie do swobodnej nauki języka.
Wybór między nimi
Jeśli zaczynasz od zera, a Twój system nauki obsługuje FSRS, nie ma większego powodu, by używać SM-2. Podejście oparte na modelu jest dokładniejsze, bardziej elastyczne i daje lepsze wyniki na dużą skalę. Krzywa uczenia się dla użytkownika jest minimalna — nadal oceniasz karty w ten sam sposób; algorytm po prostu inteligentniej wykorzystuje te oceny.
Jeśli masz istniejącą talię SM-2 z latami historii powtórek, migracja do FSRS może, ale nie musi być prosta, w zależności od narzędzia. Niektóre systemy potrafią oszacować stabilność FSRS na podstawie historii SM-2; inne zaczynają od zera. Warto sprawdzić ścieżkę migracji przed podjęciem decyzji.
Dla każdego, kto poważnie traktuje aktywne przypominanie jako długoterminową praktykę, algorytm ma coraz większe znaczenie w miarę rozrastania się talii. Kilkaset kart powtarzanych swobodnie może nie ujawnić różnicy; dziesiątki tysięcy kart studiowanych przez lata sprawiają, że każdy zysk w efektywności znacząco się kumuluje.
Najlepszy algorytm harmonogramowania to ten, którego naprawdę będziesz używać konsekwentnie. Ale przy równym zaangażowaniu FSRS daje dokładniejsze harmonogramy, bardziej jawną kontrolę nad zapamiętywaniem i lepszą efektywność na dużą skalę.
Algorytmy harmonogramowania a szersza pętla uczenia się
Warto pamiętać, że harmonogramowanie to jeden ze składników systemu nauki, a nie jego całość. Jakość powtarzanych fiszek, Twoje zaangażowanie podczas pierwszego czytania, głębia zrozumienia, którą wnosisz do każdej próby przypomnienia — czynniki te współdziałają z algorytmem harmonogramowania, określając rzeczywiste efekty uczenia się. Przeciętna karta zaharmonogramowana idealnie nadal pozostaje przeciętną kartą.
Wartość FSRS polega na tym, że usuwa wąskie gardło harmonogramowania. Gdy algorytm dokładnie modeluje Twoją pamięć i odpowiednio ustawia interwały, pozostałe zmienne są w Twojej gestii: jak czytasz, jak generujesz karty, jak uczciwie oceniasz i jak konsekwentnie pojawiasz się na powtórkach.
LearnBook używa FSRS w całym procesie — więc gdy powtarzasz materiał z wielu źródeł naraz, każda karta w kolejce obejmującej wiele książek nosi własny, niezależnie skalibrowany interwał, zamiast być wciskana we wspólny harmonogram. Aby zobaczyć FSRS w praktyce w pełnym przepływie nauki, przeczytaj o tym, jak generowane i harmonogramowane są fiszki oraz quizy.
Udostępnij
Related Posts
Powtórki rozłożone w czasie i FSRS
FSRS przewiduje, kiedy zapomnisz każdą fiszkę, i odpowiednio planuje powtórki. Przejrzyste spojrzenie na model stojący za powtórkami w LearnBook.
2026-06-18T16:09:28+08:00
Powtórki rozłożone w czasie i FSRS
Powtórki rozłożone w czasie planują przypomnienia w coraz dłuższych odstępach, tuż zanim zaczniesz zapominać. Oto jak to działa i dlaczego jest tak skuteczne.
2026-06-18T16:09:28+08:00