Loading page
Spaced repetition & FSRSgepubliceerd op
FSRS vs SM-2: waarom je planningsalgoritme ertoe doet
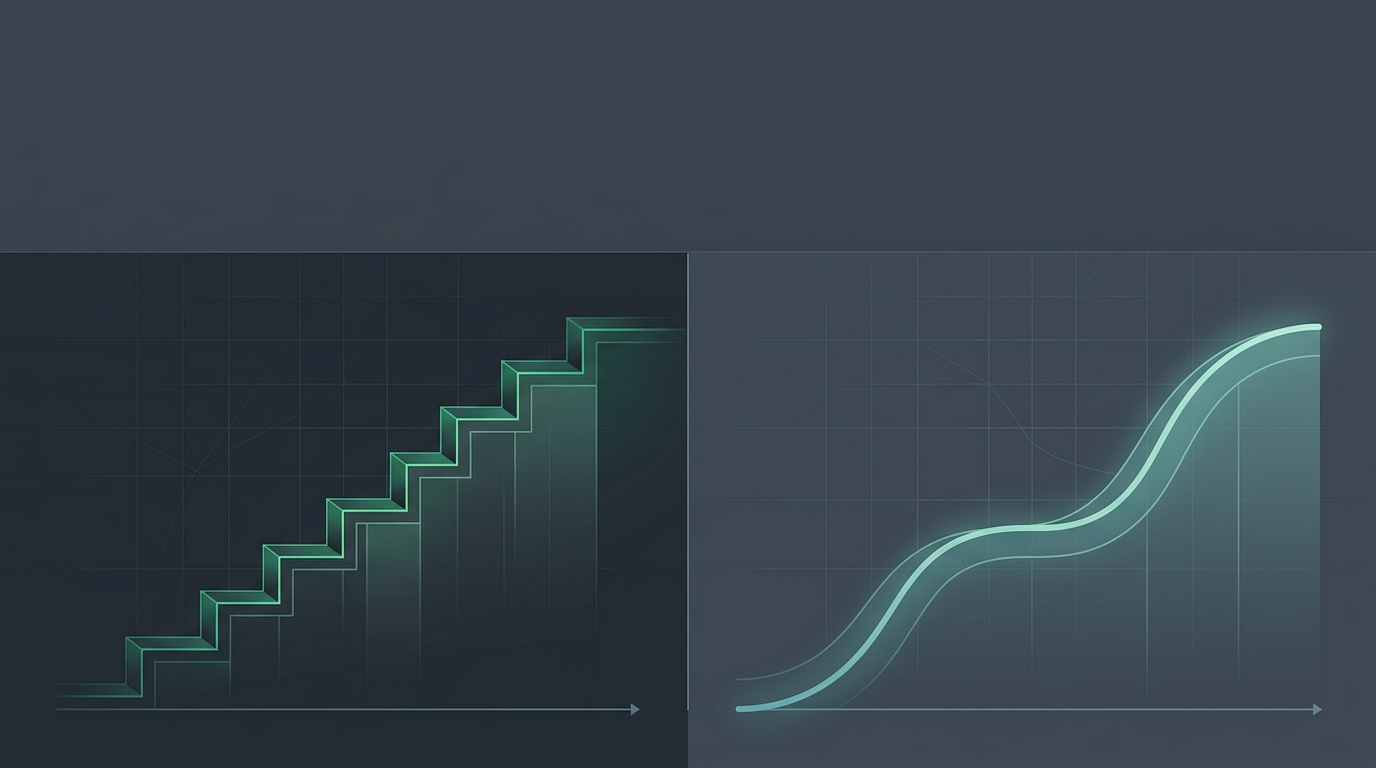
Als je Anki hebt gebruikt, ben je ingepland door SM-2. Als je een nieuwer systeem met "geoptimaliseerde planning" hebt gebruikt, ben je mogelijk FSRS tegengekomen. Beide algoritmes dienen hetzelfde doel — beslissen wanneer je elke flashcard de volgende keer te zien krijgt — maar ze doen dit op fundamenteel verschillende manieren. Het verschil is belangrijker dan de meeste lerenden beseffen, want je planningsalgoritme bepaalt hoeveel tijd je aan herhalen besteedt, hoe goed je het materiaal daadwerkelijk onthoudt, en hoe het systeem reageert wanneer je geheugen zich onverwacht gedraagt. Voor context over alle beschikbare opties voor gespreide herhaling kun je de gidscollectie gespreide herhaling doorbladeren.
SM-2: de klassieke heuristiek
SM-2 werd in de jaren 80 ontwikkeld door Piotr Wozniak voor SuperMemo en is sinds het ontstaan van Anki het standaard planningsalgoritme. Het ontwerp weerspiegelt de beperkingen van die tijd: het moest eenvoudig genoeg zijn om op vroege personal computers te draaien en verklaarbaar genoeg voor gebruikers om het handmatig te begrijpen.
SM-2 werkt ruwweg als volgt. Elke kaart draagt een ease-factor — een vermenigvuldigingsfactor die begint bij een standaardwaarde (meestal 2,5) en zich aanpast op basis van je beoordelingen. Na de eerste twee leerstappen (die vaste korte intervallen gebruiken) wordt het volgende interval berekend door het vorige interval met de ease-factor te vermenigvuldigen. Als je een kaart als Moeilijk beoordeelt, daalt de ease-factor, wat toekomstige intervallen verkort. Als je hem als Makkelijk beoordeelt, neemt hij licht toe, wat ze verlengt. Een kaart waar je herhaaldelijk mee worstelt accumuleert geleidelijk een lage ease-factor en wordt vaker herhaald; een kaart die je consequent goed hebt wordt verder de toekomst in geschoven.
Dit ontwerp werkt goed genoeg om echt nuttig te zijn — miljoenen lerenden hebben substantiële kennis opgebouwd met SM-2. Maar het heeft structurele beperkingen die duidelijk worden wanneer je op grote schaal studeert of de onderliggende aannames analyseert.
Belangrijkste beperkingen van SM-2
- Drift van de ease-factor. Zodra een ease-factor daalt — door Moeilijk- of Opnieuw-beoordelingen — neigt hij laag te blijven. Kaarten kunnen "vast komen te zitten" in korte intervallen, zelfs nadat de lerende het materiaal duidelijk heeft geïnternaliseerd, wat leidt tot overmatige herhaling van stabiele herinneringen.
- Geen expliciet vergeetmodel. SM-2 voorspelt niet wanneer je zult vergeten; het past een heuristische vermenigvuldigingsfactor toe op het vorige interval. De resulterende planning komt al dan niet overeen met het werkelijke geheugenverval voor een bepaalde kaart en lerende.
- Aanname van uniform verval. Het algoritme gaat ervan uit dat alle kaarten met vergelijkbare snelheden vervallen, alleen gecorrigeerd door de ease-factor. Het heeft geen concept van verschillende stabiliteitsniveaus die voortkomen uit de geschiedenis en het patroon van eerdere herhalingen.
- Cold-start-starheid. Elke nieuwe kaart begint met dezelfde standaard ease-factor, ongeacht hoe vergelijkbare inhoud in het verleden is behandeld. Het systeem leert je patronen niet over kaarten heen.
FSRS: een geheugenmodel, geen heuristiek
FSRS — de Free Spaced Repetition Scheduler — kiest een ander startpunt. In plaats van regels te definiëren voor hoe intervallen zouden moeten veranderen, bouwt het een wiskundig model van het geheugen zelf en leidt het de intervallen uit dat model af. Het algoritme is open source en collegiaal getoetst; zie de FSRS open-source-repository voor de technische specificatie.
Zoals uitvoeriger beschreven in Hoe FSRS werkt, volgt het model drie grootheden voor elke kaart: moeilijkheid (intrinsieke moeilijkheidsgraad voor deze lerende), stabiliteit (hoe langzaam het geheugen vervalt) en ophaalbaarheid (waarschijnlijkheid van succesvolle herinnering op dit moment). De volgende herhaling wordt gepland voor het moment waarop de ophaalbaarheid naar verwachting een streefdrempel bereikt — meestal 90 %.
Omdat het model expliciete voorspellingen doet over de herinneringskans, kan het intervallen instellen die lang zijn wanneer het geheugen werkelijk stabiel is en kort wanneer het fragiel is — beslissingen die SM-2 alleen kan benaderen via zijn ease-factormechanisme.
Directe vergelijking
| Eigenschap | SM-2 | FSRS |
|---|---|---|
| Kernmechanisme | Ease-factorheuristiek toegepast op het vorige interval | Geheugenmodel dat ophaalbaarheid over tijd voorspelt |
| Afleiding van het interval | Vorig interval × ease-factor | Tijd totdat de ophaalbaarheid daalt tot de streefdrempel |
| Retentiedoel | Impliciet — geen expliciete retentiekans | Expliciet — instelbaar doel (bijv. 90 %) |
| Aanpassing per lerende | Alleen ease-factoraanpassingen per kaart | Modelgewichten kunnen worden afgestemd op individuele herhalingsgeschiedenis |
| Drift van de ease-factor | Ja — lage ease-factoren neigen te blijven bestaan | Niet van toepassing — stabiliteit vervangt de ease-factor |
| Gebruikt beoordelingssignaal | Past ease-factor en intervalvermenigvuldiger aan | Werkt stabiliteit en moeilijkheid bij; leidt interval opnieuw af |
| Transparantie | Eenvoudige regels, gemakkelijk handmatig uit te leggen | Complexer model, maar expliciete retentievoorspellingen |
| Herhalingsefficiëntie | Goed voor de meeste toepassingen | Doorgaans minder herhalingen voor gelijkwaardige retentie |
Waarom het algoritme de herhalingsefficiëntie beïnvloedt
Het verschil in herhalingsefficiëntie tussen de twee algoritmes komt neer op hoe goed elk de werkelijke toestand van je geheugen volgt. SM-2 gebruikt een proxy — de ease-factor en de accumulatie ervan over eerdere herhalingen — die correleert met geheugenstabiliteit maar deze niet rechtstreeks meet. Het resultaat is een planning die gemiddeld redelijk is, maar onnauwkeurig voor individuele kaarten.
FSRS kan, door stabiliteit expliciet te volgen, onderscheid maken tussen twee situaties die SM-2 op dezelfde manier behandelt: een kaart met een lage ease-factor die je onlangs hebt geconsolideerd door een reeks Goed-herhalingen, en een kaart met een lage ease-factor die werkelijk fragiel blijft. SM-2 geeft beide ongeveer hetzelfde korte interval; FSRS geeft de geconsolideerde kaart een langer interval omdat de stabiliteit ervan is gegroeid.
Over een grote stapel die maandenlang wordt bestudeerd, stapelt deze precisie zich op. Stabiele herinneringen worden niet onnodig herhaald; fragiele herinneringen worden herhaald voordat ze onder de retentiedrempel zakken. Het netto-effect is een herhalingswachtrij die kleiner en beter gericht is, wat betekent minder tijd besteed aan herhalen terwijl dezelfde — of hogere — werkelijke retentie behouden blijft.
Afwegingen en praktische overwegingen
SM-2 is niet zonder voordelen. Het is uiterst transparant: je kunt het algoritme in een paar regels lezen en precies begrijpen wat het vervolgens zal doen. Het heeft decennia aan validatie in de praktijk. En voor lerenden met kleine stapels of korte studietijdlijnen kan het efficiëntieverschil tussen SM-2 en FSRS in de praktijk verwaarloosbaar zijn.
FSRS introduceert meer complexiteit. Het model heeft parameters die zinnige standaardwaarden nodig hebben — en idealiter kalibratie op jouw gegevens. Het vereist een consistente beoordelingsdiscipline, want onnauwkeurige beoordelingen misleiden een model meer dan ze een heuristiek misleiden. Voor een lerende die kaarten slordig beoordeelt of een binaire geslaagd/gezakt-aanpak gebruikt, slinkt het voordeel van FSRS aanzienlijk.
De andere belangrijke overweging is wat "retentie" in elk systeem betekent. SM-2 geeft je geen retentiedoel om in te stellen; de resulterende retentie hangt af van de standaard ease-factor en hoe je kaarten beoordeelt. FSRS laat je je doel expliciet kiezen — 70 %, 90 %, 95 % — en past intervallen aan om het te handhaven. Hogere doelen betekenen kortere intervallen en meer herhalingen; lagere doelen betekenen langere intervallen en meer vergeten. Expliciete controle over deze afweging hebben is nuttig wanneer je sterke meningen hebt over hoe betrouwbaar je herinnering moet zijn, zoals bij een professionele certificering versus losse taalverwerving.
Een keuze tussen beide maken
Als je opnieuw begint en je studiesysteem FSRS ondersteunt, is er weinig reden om SM-2 te gebruiken. De modelgebaseerde aanpak is nauwkeuriger, beter aanpasbaar en levert betere resultaten op grote schaal. De leercurve voor de gebruiker is minimaal — je beoordeelt kaarten nog steeds op dezelfde manier; het algoritme gebruikt die beoordelingen alleen intelligenter.
Als je een bestaande SM-2-stapel met jaren herhalingsgeschiedenis hebt, kan migreren naar FSRS al dan niet eenvoudig zijn, afhankelijk van je tool. Sommige systemen kunnen de FSRS-stabiliteit schatten uit de SM-2-geschiedenis; andere beginnen opnieuw. Het is de moeite waard om het migratiepad te controleren voordat je je vastlegt.
Voor iedereen die serieus is over actieve recall als een langetermijnpraktijk, wordt het algoritme steeds belangrijker naarmate de stapel groeit. Een paar honderd kaarten die losjes worden herhaald onthullen het verschil misschien niet; tienduizenden kaarten die jarenlang worden bestudeerd zorgen ervoor dat elke efficiëntiewinst zich betekenisvol opstapelt.
Het beste planningsalgoritme is het algoritme dat je daadwerkelijk consistent zult gebruiken. Maar bij gelijke toewijding produceert FSRS nauwkeurigere planningen, meer expliciete retentiecontrole en betere efficiëntie op grote schaal.
Planningsalgoritmes en de bredere leercyclus
Het is goed om te onthouden dat planning één onderdeel van een leersysteem is, niet het geheel ervan. De kwaliteit van de flashcards die je herhaalt, je betrokkenheid tijdens het aanvankelijke lezen, de diepte van het begrip dat je bij elke herinneringspoging inbrengt — deze factoren werken samen met het planningsalgoritme om de werkelijke leeruitkomsten te bepalen. Een middelmatige kaart die perfect is ingepland blijft een middelmatige kaart.
De waarde van FSRS is dat het de planningsknelpunt wegneemt. Zodra het algoritme je geheugen nauwkeurig modelleert en intervallen passend instelt, liggen de resterende variabelen in jouw handen: hoe je leest, hoe je kaarten genereert, hoe eerlijk je beoordeelt, en hoe consistent je komt opdagen voor herhalingen.
LearnBook gebruikt overal FSRS — dus wanneer je materiaal uit meerdere bronnen tegelijk herhaalt, draagt elke kaart in de wachtrij over boeken heen zijn eigen onafhankelijk gekalibreerde interval in plaats van te worden geforceerd in een gedeelde planning. Om FSRS in de praktijk te zien binnen de volledige studieworkflow, lees over hoe flashcards en quizzen worden gegenereerd en ingepland.
Delen
Related Posts
Spaced repetition & FSRS
FSRS voorspelt wanneer je elke kaart vergeet en plant de herhalingen daarop. Een helder beeld van het model achter de herhalingen in LearnBook.
2026-06-18T16:09:01+08:00
Spaced repetition & FSRS
Spaced repetition plant herhalingen met toenemende intervallen, net voordat je zou vergeten. Zo werkt het en daarom is het zo effectief.
2026-06-18T16:09:01+08:00