Loading page
LearnBookでPDF・動画・ノートをコースに変える
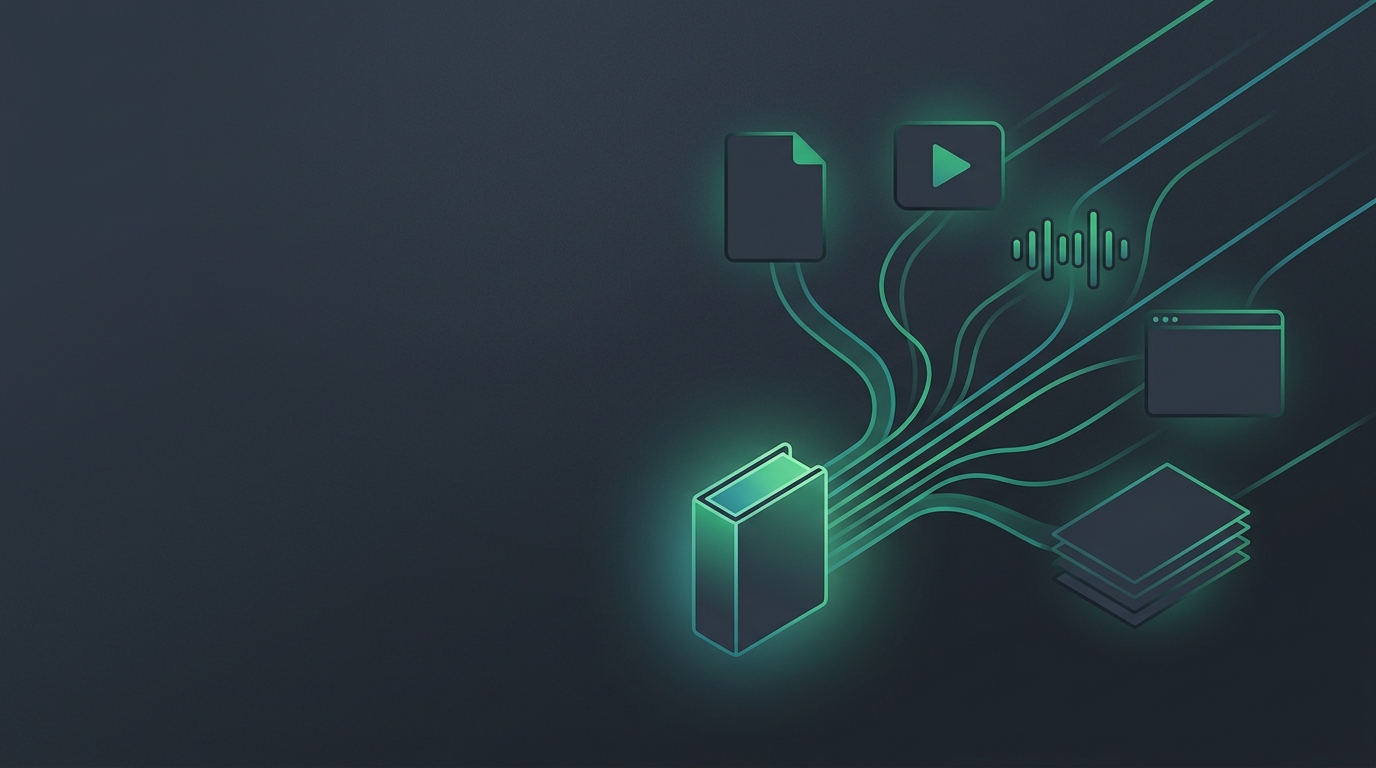
ほとんどの学習教材は、きれいに整った形式で届くわけではありません。PDFの研究論文、三週間前にブックマークしたYouTubeの講義、学会で録音したボイスメモ、そして読もうと思っていた十数個のブラウザタブ。LearnBookはまさにこの状況のために作られました。その中核となる約束——「Learn Anything to Book, by AI」——は、あなたのソースがどんな形であろうと、LearnBookがそれを構造化された、学習可能なコース——実際にやり通せるもの——にコンパイルできることを意味します。本ガイドは、サポートされている各ソースタイプのインポート方法を順を追って説明し、コンパイルを押したときに何が起こるかを解説します。これはLearnBookを使う最初のステップです。プラットフォームの全機能はLearnBookの使い方ガイドで探ってみてください。
なぜ「アップロード」ではなく「コンパイル」なのか
ファイルをアップロードすることは、デバイスからサーバーへバイトを移動させることです。コンパイルはそれとは違うことをします。生のコンテンツを解析し、意味のある構造を抽出し、ナビゲート可能なアウトラインを作成し、すべての主張をそれが由来するパッセージへとリンクし、そして想起アイテム——フラッシュカードとクイズ問題——を事前に生成して、すぐに学習を始められるようにします。コンパイルされた結果は、ソースの静的なコピーではありません。それは、AIチューターが活用できる文脈と、数週間にわたってあなたについて回る復習キューを備えた、生きた学習オブジェクトです。この区別は重要です。なぜなら、目的は保存ではなく——習得だからです。
サポートされているソースタイプ
LearnBookは幅広い入力形式を受け付けるので、「もっと扱いやすければこれを学習するのに」が学習しない理由でなくなります。
PDFとEPUB
これらは最も一般的な学術形式です。LearnBookはこれらをページごとに解析し、見出し、節の区切り、そして——PDFが整った形式であれば——図のキャプションや表を保持します。EPUBファイルはその章構造を保ち、コンパイルされたコース内のナビゲーションをより細かくします。コンパイル後は、AIチューターが返すすべての答えが、記憶からの言い換えではなく、特定のページとパッセージを引用できます。
ウェブページと記事
URLを貼り付けるか共有すると、LearnBookは記事を取得し、ナビゲーションの装飾を取り除き、本文コンテンツを処理します。これは長文ジャーナリズム、ドキュメントページ、研究プレプリント、ブログ記事にうまく機能します。元のURLがコンパイルされたテキストと並んで保存されるため、引用はライブのソースへリンクで戻ります。
YouTubeと講義の字幕
YouTubeのリンクを共有すると、LearnBookは字幕トラックを取得し、それを大まかなトランスクリプト構造に整え、テキストベースのコースとしてコンパイルします。これは、二時間の講義が、ざっと目を通し、質問し、復習できるものになることを意味します——ディテールを確認したいたびに動画を巻き戻す必要はありません。タイムスタンプの参照が保持されるため、引用は動画の正しい瞬間を指し示します。
ポッドキャストと音声ファイル
音声ソース——ポッドキャストのエピソード、録音されたセミナー、ボイスメモ——は、コンパイルの前に自動音声認識を経ます。出来上がったトランスクリプトは、その後あらゆるテキストソースと同じ方法で処理されます。音声品質はトランスクリプトの精度に影響するため、クリアな録音はより良い結果を生みますが、ワークフローは形式にかかわらず同じです。
PowerPointとプレゼンテーションファイル
スライドデッキは、箇条書きが密で散文が乏しいことが多く、それだけでは学習しづらいものです。LearnBookはスライドのテキスト、存在する場合は発表者ノート、そしてスライドの順序を抽出して、構造化されたアウトラインを構築します。コンパイルされたコースは、その後、AIチューターが推論できる文脈を補い、謎めいた箇条書きが何を意味していたのかをあなたが推測するのに任せることがありません。
プレーンノートとMarkdown
あなた自身のノート——粗いMarkdownファイル、貼り付けたテキスト、あるいは積み上げてきた長いドキュメントであれ——もコースにコンパイルできます。これは、知識の山を復習が組み込まれたものに変えたいとき、あるいは自分のノートを他のソース教材と組み合わせたいときに役立ちます。
OCRによる画像
ホワイトボードの写真、スキャンした教科書のページ、手書きノートのスナップショットは、コンパイルの前に光学文字認識(OCR)を経て処理されます。抽出されたテキストは、その後、同じコンパイルパイプラインを通ります。OCRの精度は画像の鮮明さに依存しますが、印刷物や明瞭な手書き文字の読み取りやすい写真はうまく機能します。
インポートとコンパイルのワークフロー
- ソースを追加する。URLを貼り付ける、ファイルをアップロードする、あるいはテキストを直接貼り付ける。LearnBookは、あなたが持っているどんな形であれ、生の素材を受け付けます。
- LearnBookにコンパイルさせる。コンパイルのステップは、構造を解析し、重要な概念を抽出し、ナビゲート可能なアウトラインを構築し、ソーステキストに根ざしたフラッシュカードとクイズ問題の初期セットを生成します。長いドキュメントの場合は少し時間がかかります。短い記事の場合はほぼ瞬時です。
- コンパイルされたコースを確認する。明確なアウトラインと節ごとのナビゲーションを備えた、教材の構造化されたビューが得られます。元のソースの見出しが、あなたの学習ガイドの背骨になります。
- 読んで質問を始める。任意の節を開き、AIチューターが質問に答えられる状態で読みましょう。チューターは——一般的なインターネットではなく——あなたの特定のソースに根ざしているため、その答えは一般的な説明を提示するのではなく、それが由来するパッセージを引用します。
- 生成された想起アイテムを学習する。コンパイル中に生成されたフラッシュカードとクイズ問題は、すでに復習キューに入っており、FSRS間隔反復アルゴリズムによってスケジュールされています。すぐに復習することも、スケジュールが適切なタイミングで届けるのに任せることもできます。
コンパイルが作り出すもの
コンパイル後、あなたのソースは読めるドキュメント以上のものになります。コンパイルのステップは、相互に関連する三つの資産を生み出します。
- 構造化されたアウトライン——節ごとにナビゲート可能で、スクロールするのではなく必要な部分に直接ジャンプできます。
- 引用アンカー——すべてのAIチューターの答えと、生成されたすべてのフラッシュカードが、それを裏付けるソース内の特定のパッセージへとリンクで戻ります。これがシステムを信頼できるものにしているものです。主張がどこから来たのかを、いつでも検証できます。
- 初期の想起セット——コンパイルされたコンテンツから引き出されたフラッシュカードとクイズ問題で、間隔反復の復習に向けて準備が整っています。これらは一般的なものではなく、あなたの教材にある特定の論証、事実、構造に根ざしています。
より良いコンパイル結果のためのヒント
実際のソースを扱う中で得た実践的なメモをいくつか挙げます。
- よく構造化されたPDF——特大の太字テキストではなく、実際の見出しタグを持つもの——は、コンパイル後によりきれいなアウトラインを生みます。
- 自動生成された字幕を持つYouTube動画もコンパイルは成功しますが、手動で作成された字幕を持つ動画(学術系チャンネルで一般的)のほうが、より正確なトランスクリプトを生みます。
- 非常に長いソースをインポートする場合は、それを一つのコースとするのが理にかなっているか、それとも主要な節を別々にコンパイルしてより焦点を絞った復習セッションにするほうがよいかを検討してみてください。
- あなた自身のノートは、ある程度の構造を持っているときに最もうまくコンパイルされることが多いです——最小限の見出しであっても、LearnBookがあなたの知っていることの形を理解する助けになります。
あらゆるソースから、実際に学習できるコースへ
インポートとコンパイルのワークフローは、LearnBookの学習ループへの入口です。すなわち、インポート → コンパイル → 読んで質問 → クイズとフラッシュカード → 復習。ソースがコンパイルされると、AIチューターと復習システムが引き継ぎ、読んだことが実際に定着するようにします。各ステップは、ある段階に注いだ努力が、それに続くすべての段階で報われるように設計されています。ソースを上手くコンパイルすることは、AIチューターの答えがより正確になり、フラッシュカードがより関連性の高いものになり、復習セッションがより効率的になることを意味します。教材が届く形式が、それを効果的に学習できるかどうかを決めてはならない——それを決めさせないことが、LearnBookの仕事です。
始める準備はできましたか。PDF、講義のリンク、あるいはあなた自身のノートを取り込んで、LearnBookで最初のコースをコンパイルしましょう。ループ全体——生の素材から復習による習得まで——は、たった一回のインポートから始まります。
共有
Related Posts
LearnBookの使い方
出典に基づいた質問をし、ソクラテス式の解説を受け、FSRSに復習をスケジュールさせる。LearnBookの学習ループを案内します。
2026-06-18T15:27:48+08:00
LearnBookの使い方
LearnBookはあらゆるソースを、原文に基づいたフラッシュカードとクイズに変えます。その生成方法と使い方を紹介します。
2026-06-18T15:27:48+08:00