Loading page
間隔反復とFSRS公開日
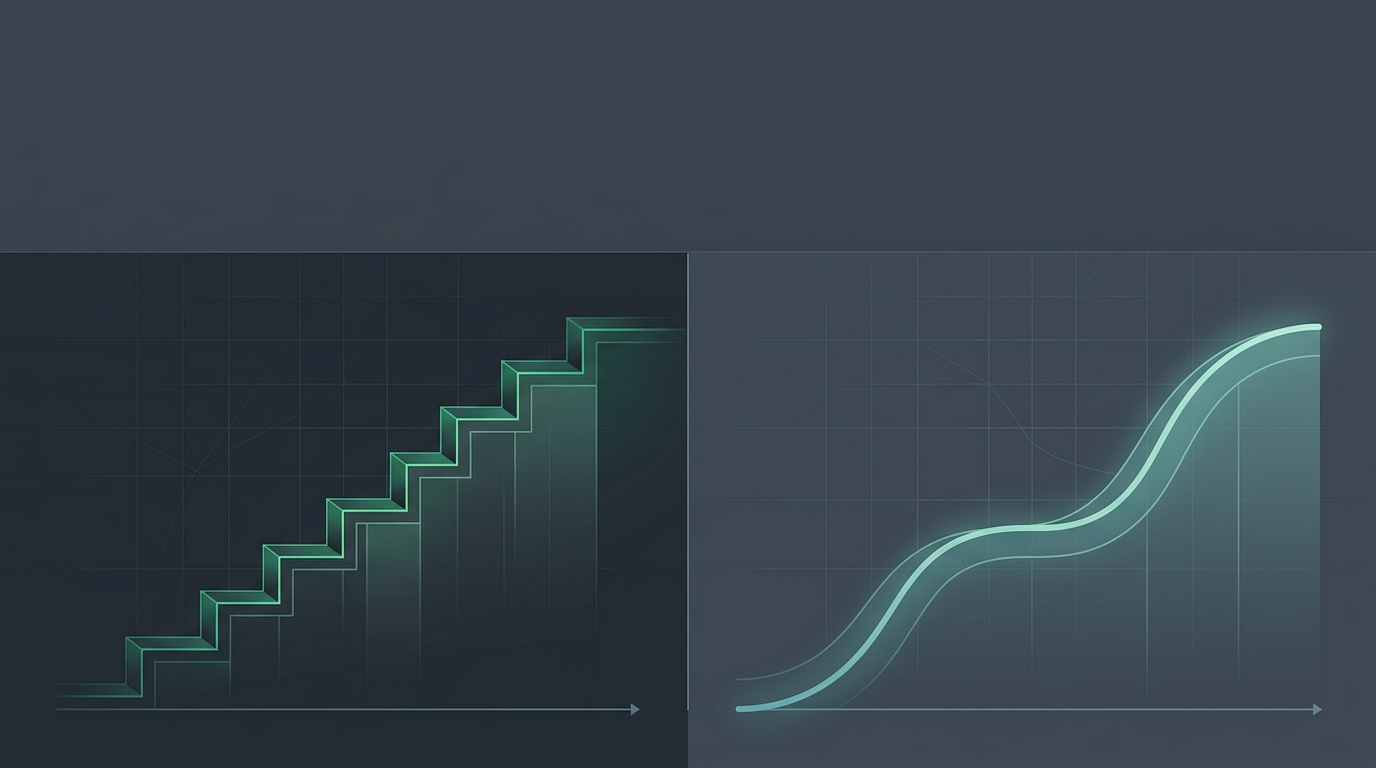
FSRS対SM-2:スケジューリングアルゴリズムが重要な理由
Anki を使ったことがあるなら、あなたは SM-2 によってスケジュールされてきました。「最適化されたスケジューリング」を備えた新しいシステムを使ったことがあるなら、FSRS に出会ったことがあるかもしれません。どちらのアルゴリズムも同じ目的 — 各フラッシュカードを次にいつ見せるかを決めること — に役立ちますが、その方法は根本的に異なります。この違いは、ほとんどの学習者が気づいているよりも重要です。なぜなら、あなたのスケジューリングアルゴリズムは、復習にどれだけ時間を費やすか、教材を実際にどれだけよく定着させられるか、そして記憶が予想外の振る舞いをしたときにシステムがどう応答するかを決めるからです。利用可能なすべての間隔反復の選択肢についての背景は、間隔反復のガイドコレクションをご覧ください。
SM-2: 古典的なヒューリスティック
SM-2 は 1980 年代に Piotr Wozniak によって SuperMemo のために開発され、Anki ではその誕生以来デフォルトのスケジューリングアルゴリズムとなってきました。その設計は当時の制約を反映しています。初期のパーソナルコンピュータ上で動くほどシンプルで、ユーザーが手作業で理解できるほど説明可能である必要があったのです。
SM-2 はおおよそ次のように動きます。各カードは易しさ係数を持ちます — デフォルト値(通常 2.5)から始まり、あなたの評価に基づいて調整される倍率です。最初の2つの学習ステップ(固定された短い間隔を使う)の後、次の間隔は前の間隔に易しさ係数を掛けて計算されます。カードを Hard と評価すると易しさ係数は減少し、今後の間隔を短くします。Easy と評価するとわずかに増加し、間隔を延ばします。何度も苦戦するカードは徐々に低い易しさ係数を蓄積してより頻繁に復習されるようになり、一貫して正解するカードはより遠い未来へ押しやられます。
この設計は、本当に役立つほどには十分うまく機能します — 数百万人の学習者が SM-2 を使って相当な知識を築いてきました。しかし、大規模に学習したり、基盤となる前提を分析したりすると明らかになる構造的な限界があります。
SM-2 の主な限界
- 易しさ係数のドリフト。一度易しさ係数が減少すると — Hard や Again の評価によって — それは低いまま留まる傾向があります。学習者が明らかに教材を内面化した後でも、カードが短い間隔に「閉じ込められて」しまい、安定した記憶の過剰な復習につながることがあります。
- 明示的な忘却モデルの欠如。SM-2 はあなたがいつ忘れるかを予測しません。前の間隔にヒューリスティックな倍率を適用するだけです。その結果のスケジュールは、特定のカードと学習者にとっての実際の記憶減衰と一致するかもしれないし、しないかもしれません。
- 一様な減衰の前提。このアルゴリズムは、すべてのカードが同程度の速さで減衰すると仮定し、易しさ係数によってのみ調整します。過去の復習の履歴やパターンから生じる、異なる安定度レベルという概念を持っていません。
- コールドスタートの硬直性。すべての新しいカードは、過去に似た内容がどう扱われたかに関わらず、同じデフォルトの易しさ係数から始まります。システムはカードをまたいであなたのパターンを学習しません。
FSRS: ヒューリスティックではなく記憶モデル
FSRS — the Free Spaced Repetition Scheduler — は異なる出発点を取ります。間隔がどう変化すべきかのルールを定義する代わりに、記憶そのものの数学的モデルを構築し、そのモデルから間隔を導出します。このアルゴリズムはオープンソースで査読されています。技術仕様については FSRS のオープンソースリポジトリをご覧ください。
FSRS の仕組みでより詳しく説明されているように、このモデルは各カードについて3つの量を追跡します。難易度(この学習者にとっての本質的な覚えにくさ)、安定度(記憶がどれだけゆっくり減衰するか)、想起可能性(この瞬間に正しく想起できる確率)です。次の復習は、想起可能性が目標のしきい値 — 一般的には 90 % — に達すると予測される時点にスケジュールされます。
このモデルは想起確率について明示的な予測を行うため、記憶が本当に安定しているときには長く、脆いときには短い間隔を設定できます — SM-2 が易しさ係数の仕組みを通じて近似することしかできない判断です。
正面からの比較
| 特性 | SM-2 | FSRS |
|---|---|---|
| 中核の仕組み | 前の間隔に適用される易しさ係数ヒューリスティック | 時間経過に伴う想起可能性を予測する記憶モデル |
| 間隔の導出 | 前の間隔 × 易しさ係数 | 想起可能性が目標のしきい値まで下がるまでの時間 |
| 定着の目標設定 | 暗黙的 — 明示的な定着確率なし | 明示的 — 設定可能な目標(例: 90 %) |
| 学習者ごとの適応 | カードごとの易しさ係数の調整のみ | モデルの重みを個々の復習履歴にフィッティング可能 |
| 易しさ係数のドリフト | あり — 低い易しさ係数は持続する傾向がある | 該当なし — 安定度が易しさ係数を置き換える |
| 使われる評価シグナル | 易しさ係数と間隔の倍率を調整する | 安定度と難易度を更新し、間隔を再導出する |
| 透明性 | シンプルなルール、手作業で説明しやすい | より複雑なモデル、しかし明示的な定着予測あり |
| 復習効率 | ほとんどのユースケースで良好 | 同等の定着に対して一般的により少ない復習 |
なぜアルゴリズムが復習効率に影響するか
2つのアルゴリズムの復習効率の違いは、それぞれがあなたの記憶の実際の状態をどれだけよく追跡するかに帰着します。SM-2 は代理指標 — 易しさ係数と過去の復習にわたるその蓄積 — を使います。これは記憶の安定度と相関しますが、それを直接測定するわけではありません。その結果は、平均的には妥当だが、個々のカードについては不正確なスケジュールです。
FSRS は安定度を明示的に追跡することで、SM-2 が同様に扱う2つの状況を区別できます。Good の連続によって最近固定化された、低い易しさ係数のカードと、本当に脆いままの、低い易しさ係数のカードです。SM-2 はどちらにもおおよそ同じ短い間隔を与えますが、FSRS は固定化されたカードには、その安定度が増したため、より長い間隔を与えます。
何か月も学習する大規模なデッキにわたって、この精度は複利的に効いてきます。安定した記憶は不必要に復習されず、脆い記憶は定着のしきい値を下回る前に復習されます。正味の効果は、より小さく、よりよく狙いの定まった復習キューであり、これは同じ — あるいはより高い — 実際の定着を維持しながら、復習に費やす時間が少なくなることを意味します。
トレードオフと実践的な考慮事項
SM-2 に利点がないわけではありません。きわめて透明性が高く、数行でアルゴリズムを読み、次に何をするかを正確に理解できます。何十年もの実世界での検証があります。そして小さなデッキや短い学習期間の学習者にとっては、SM-2 と FSRS の効率の差は実際にはごくわずかかもしれません。
FSRS はより多くの複雑さを導入します。モデルには妥当なデフォルト値 — そして理想的には、あなたのデータへの較正 — を必要とするパラメータがあります。また一貫した評価の規律を要します。なぜなら不正確な評価は、ヒューリスティックを誤らせる以上にモデルを誤らせるからです。カードをいいかげんに評価したり、二者択一の合否方式を使ったりする学習者にとっては、FSRS の優位性は大きく縮みます。
もう一つの重要な考慮事項は、各システムにおいて「定着」が何を意味するかです。SM-2 は設定すべき定着目標を与えません。結果として得られる定着は、デフォルトの易しさ係数とあなたのカードの評価のしかたに依存します。FSRS では目標を明示的に選べます — 70 %、90 %、95 % — そしてそれを維持するように間隔を調整します。目標が高いほど間隔は短く復習は多くなり、目標が低いほど間隔は長く忘却は多くなります。このトレードオフを明示的に制御できることは、専門資格の取得とカジュアルな語学学習のように、自分の想起がどれだけ信頼できる必要があるかについて強い意見がある場合に役立ちます。
どちらを選ぶか
新たに始めるところで、学習システムが FSRS をサポートしているなら、SM-2 を使う理由はほとんどありません。モデルベースのアプローチはより正確で、より適応的で、大規模でより良い結果を生み出します。ユーザーにとっての学習コストは最小限です — あなたは同じようにカードを評価するだけで、アルゴリズムがそれらの評価をより賢く使うのです。
何年もの復習履歴を持つ既存の SM-2 デッキがある場合、FSRS への移行が容易かどうかはツールによって異なります。一部のシステムは SM-2 の履歴から FSRS の安定度を推定でき、他のシステムは新たに始めます。移行の経路は、コミットする前に確認する価値があります。
長期的な実践としてのアクティブリコールに真剣な人にとって、デッキが大きくなるにつれてアルゴリズムはますます重要になります。気軽に復習する数百枚のカードでは違いが現れないかもしれませんが、何年もかけて学習する何万枚ものカードでは、あらゆる効率の向上が意味のある形で複利的に積み上がります。
最良のスケジューリングアルゴリズムは、あなたが実際に一貫して使うものです。しかし同等のコミットメントがあれば、FSRS はより正確なスケジュール、より明示的な定着の制御、そして大規模でのより良い効率を生み出します。
スケジューリングアルゴリズムとより広い学習ループ
スケジューリングは学習システムの一構成要素であって、その全体ではないことを覚えておく価値があります。あなたが復習しているフラッシュカードの質、最初の読解中の関与度、各想起の試みに持ち込む理解の深さ — これらの要因がスケジューリングアルゴリズムと相互作用して、実際の学習成果を決めます。完璧にスケジュールされた平凡なカードは、それでも平凡なカードです。
FSRS の価値は、スケジューリングのボトルネックを取り除くことにあります。アルゴリズムがあなたの記憶を正確にモデル化し、間隔を適切に設定するようになれば、残る変数はあなたの制御下にあります。どう読むか、どうカードを生成するか、どれだけ正直に評価するか、そしてどれだけ一貫して復習に現れるかです。
LearnBook は全体を通じて FSRS を使っています — だから複数の出典の教材を一度に復習するとき、教材横断キューの各カードは、共有スケジュールに無理やり押し込まれるのではなく、それぞれ独立して較正された間隔を持ちます。完全な学習ワークフローの中での FSRS の実践を見るには、フラッシュカードとクイズがどのように生成・スケジュールされるかをお読みください。
共有
Related Posts
間隔反復とFSRS
FSRSは各カードを忘れるタイミングを予測し、それに合わせて復習をスケジュールします。LearnBookの復習を支えるモデルをわかりやすく解説します。
2026-06-18T15:27:48+08:00
間隔反復とFSRS
間隔反復は、忘れそうになる直前に、間隔を広げながら復習をスケジュールします。そのしくみと、なぜこれほど効果的なのかを解説します。
2026-06-18T15:27:48+08:00