Loading page
חזרה מרווחת ו-FSRSפורסם ב
FSRS מול SM-2: מדוע אלגוריתם התזמון שלכם חשוב
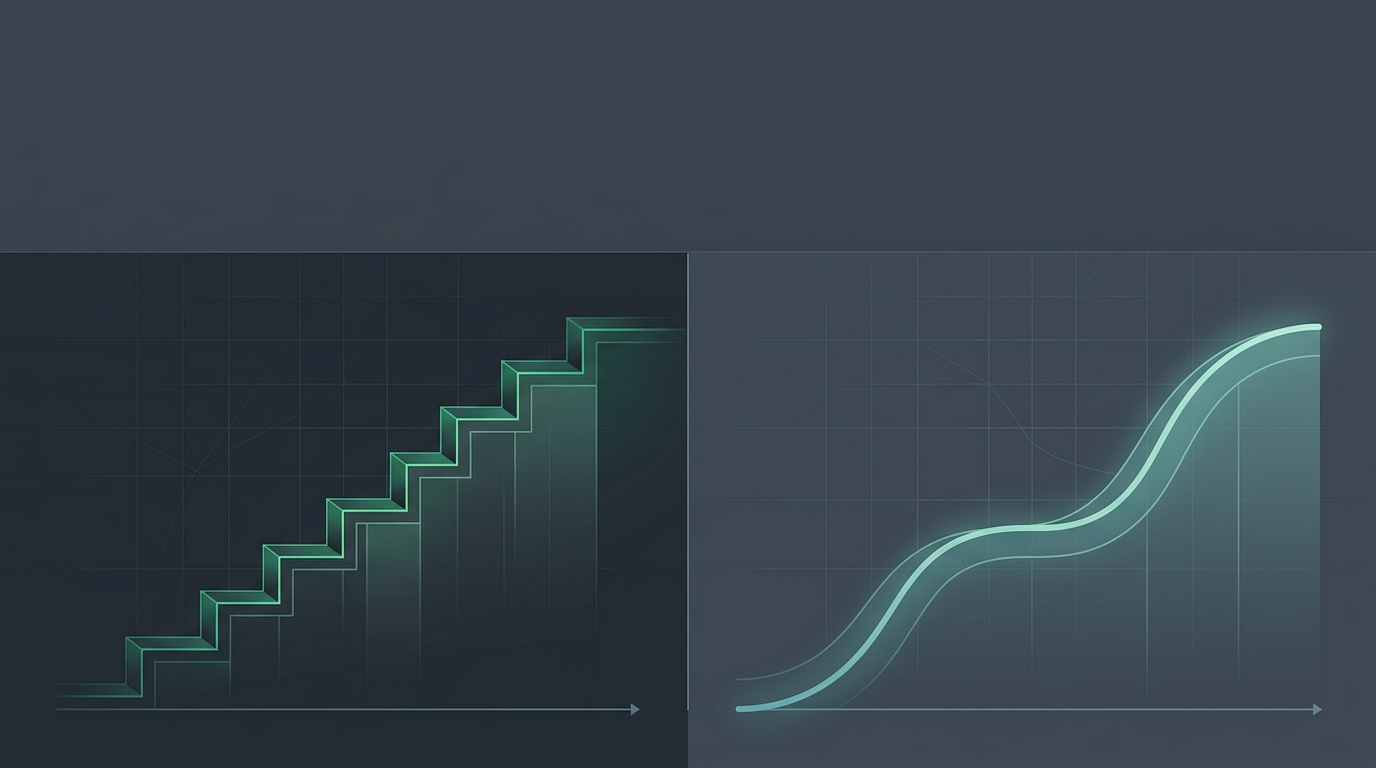
אם השתמשת ב־Anki, היית מתוזמן על ידי SM-2. אם השתמשת במערכת חדשה יותר עם "תזמון ממוטב", ייתכן שנתקלת ב־FSRS. שני האלגוריתמים משרתים את אותה מטרה — להחליט מתי להציג לך כל כרטיסייה בפעם הבאה — אך הם עושים זאת בדרכים שונות מהותית. ההבדל חשוב יותר משרוב הלומדים מבינים, משום שאלגוריתם התזמון שלך קובע כמה זמן אתה מבלה בחזרות, כמה טוב אתה באמת משמר חומר, וכיצד המערכת מגיבה כשהזיכרון שלך מתנהג באופן בלתי צפוי. לרקע על כל אפשרויות החזרה המרווחת הזמינות, עיין באוסף המדריכים על חזרה מרווחת.
SM-2: ההיוריסטיקה הקלאסית
SM-2 פותח על ידי Piotr Wozniak בשנות השמונים עבור SuperMemo והיה אלגוריתם התזמון של ברירת המחדל ב־Anki מאז יצירתו. העיצוב שלו משקף את אילוצי התקופה: הוא היה צריך להיות פשוט מספיק כדי לרוץ על מחשבים אישיים מוקדמים וניתן להסבר מספיק כדי שמשתמשים יוכלו להבין אותו באופן ידני.
SM-2 פועל בערך כך. כל כרטיס נושא גורם קלות — מכפיל שמתחיל בערך ברירת מחדל (בדרך כלל 2.5) ומתאים את עצמו בהתאם לדירוגים שלך. לאחר שני צעדי הלמידה הראשוניים (המשתמשים במרווחים קצרים קבועים), המרווח הבא מחושב על ידי הכפלת המרווח הקודם בגורם הקלות. אם אתה מדרג כרטיס כקשה, גורם הקלות יורד ומקצר את המרווחים העתידיים. אם אתה מדרג אותו כקל, הוא עולה מעט ומאריך אותם. כרטיס שאתה מתקשה בו שוב ושוב צובר בהדרגה גורם קלות נמוך ונסקר בתדירות גבוהה יותר; כרטיס שאתה תמיד פותר נכון נדחף רחוק יותר אל העתיד.
העיצוב הזה פועל מספיק טוב כדי להיות שימושי באמת — מיליוני לומדים בנו ידע מהותי תוך שימוש ב־SM-2. אך יש לו מגבלות מבניות שמתבררות כשלומדים בקנה מידה גדול או מנתחים את ההנחות הבסיסיות.
מגבלות מרכזיות של SM-2
- סחיפת גורם הקלות. ברגע שגורם קלות יורד — דרך דירוגי קשה או שוב — הוא נוטה להישאר נמוך. כרטיסים יכולים "להילכד" במרווחים קצרים גם לאחר שהלומד הפנים בבירור את החומר, מה שמוביל לחזרת־יתר על זיכרונות יציבים.
- אין מודל שכחה מפורש. SM-2 אינו חוזה מתי תשכח; הוא מחיל מכפיל היוריסטי על המרווח הקודם. הלוח שמתקבל עשוי להתיישר או לא להתיישר עם דעיכת הזיכרון בפועל עבור כרטיס ולומד נתונים.
- הנחת דעיכה אחידה. האלגוריתם מניח שכל הכרטיסים דועכים בקצב דומה, מותאם רק על ידי גורם הקלות. אין לו מושג של רמות יציבות שונות הנובעות מההיסטוריה ומהדפוס של חזרות קודמות.
- נוקשות בהתחלה קרה. כל כרטיס חדש מתחיל עם אותו גורם קלות של ברירת מחדל ללא קשר לאופן שבו טופל תוכן דומה בעבר. המערכת אינה לומדת את הדפוסים שלך בין כרטיסים.
FSRS: מודל זיכרון, לא היוריסטיקה
FSRS — ה־Free Spaced Repetition Scheduler — נוקט בנקודת פתיחה שונה. במקום להגדיר כללים לאופן שבו המרווחים צריכים להשתנות, הוא בונה מודל מתמטי של הזיכרון עצמו ונגזר ממנו את המרווחים. האלגוריתם הוא קוד פתוח ועבר ביקורת עמיתים; ראה את מאגר הקוד הפתוח של FSRS למפרט הטכני.
כפי שמתואר ביתר פירוט ב־כיצד FSRS עובד, המודל עוקב אחר שלושה גדלים עבור כל כרטיס: קושי (הקושי המהותי עבור לומד זה), יציבות (באיזו מהירות דועך הזיכרון), ושליפוּת (הסתברות לשליפה מוצלחת ברגע זה). החזרה הבאה מתוזמנת לנקודת הזמן שבה צפוי שהשליפוּת תגיע לסף יעד — לרוב 90%.
מכיוון שהמודל עושה חיזויים מפורשים לגבי הסתברות השליפה, הוא יכול לקבוע מרווחים ארוכים כשהזיכרון יציב באמת וקצרים כשהוא שביר — החלטות ש־SM-2 יכול רק לקרב באמצעות מנגנון גורם הקלות שלו.
השוואה ראש בראש
| מאפיין | SM-2 | FSRS |
|---|---|---|
| מנגנון ליבה | היוריסטיקת גורם קלות המוחלת על המרווח הקודם | מודל זיכרון החוזה שליפוּת לאורך זמן |
| גזירת מרווחים | מרווח קודם × גורם קלות | הזמן עד שהשליפוּת יורדת לסף היעד |
| כיוון שימור | משתמע — אין הסתברות שימור מפורשת | מפורש — יעד הניתן להגדרה (למשל 90%) |
| הסתגלות לכל לומד | התאמות גורם קלות לכל כרטיס בלבד | ניתן להתאים את משקלי המודל להיסטוריית חזרות אישית |
| סחיפת גורם קלות | כן — גורמי קלות נמוכים נוטים להישאר | לא רלוונטי — היציבות מחליפה את גורם הקלות |
| אות הדירוג שבשימוש | מתאים את גורם הקלות ואת מכפיל המרווח | מעדכן יציבות וקושי; נגזר מחדש את המרווח |
| שקיפות | כללים פשוטים, קל להסביר ידנית | מודל מורכב יותר, אך עם חיזויי שימור מפורשים |
| יעילות חזרה | טובה לרוב מקרי השימוש | בדרך כלל פחות חזרות עבור שימור שווה ערך |
מדוע האלגוריתם משפיע על יעילות החזרה
הבדל יעילות החזרה בין שני האלגוריתמים מסתכם באיזו מידה כל אחד מהם עוקב אחר המצב האמיתי של הזיכרון שלך. SM-2 משתמש בנציג — גורם הקלות והצטברותו לאורך חזרות קודמות — שמתואם עם יציבות הזיכרון אך אינו מודד אותה ישירות. התוצאה היא לוח סביר בממוצע אך לא מדויק עבור כרטיסים בודדים.
FSRS, על ידי מעקב מפורש אחר היציבות, יכול להבחין בין שני מצבים ש־SM-2 מתייחס אליהם באופן דומה: כרטיס בעל גורם קלות נמוך שגיבשת לאחרונה דרך רצף של חזרות טובות, וכרטיס בעל גורם קלות נמוך שנותר שביר באמת. SM-2 ייתן לשניהם בערך אותו מרווח קצר; FSRS ייתן לכרטיס המגובש מרווח ארוך יותר משום שיציבותו גדלה.
לאורך חבילה גדולה הנלמדת חודשים, הדיוק הזה מצטבר. זיכרונות יציבים אינם נסקרים שלא לצורך; זיכרונות שבירים נסקרים לפני שהם יורדים מתחת לסף השימור. ההשפעה הכוללת היא תור חזרות קטן וממוקד יותר, מה שמשמעו פחות זמן בחזרות תוך שמירה על אותו שימור בפועל — או גבוה יותר.
פשרות ושיקולים מעשיים
ל־SM-2 יש גם יתרונות. הוא שקוף ביותר: אפשר לקרוא את האלגוריתם בכמה שורות ולהבין בדיוק מה הוא יעשה הלאה. יש לו עשרות שנים של אימות בעולם האמיתי. ועבור לומדים עם חבילות קטנות או לוחות זמני לימוד קצרים, הבדל היעילות בין SM-2 ל־FSRS עשוי להיות זניח בפועל.
FSRS מציג מורכבות רבה יותר. למודל יש פרמטרים הזקוקים לערכי ברירת מחדל סבירים — ובאופן אידיאלי, כיול לנתונים שלך. הוא דורש משמעת דירוג עקבית, משום שדירוגים לא מדויקים מטעים מודל יותר מאשר הם מטעים היוריסטיקה. עבור לומד שמדרג כרטיסים ברשלנות או משתמש בגישת עבר/נכשל בינארית, היתרון של FSRS מצטמצם משמעותית.
השיקול החשוב האחר הוא מה "שימור" אומר בכל מערכת. SM-2 אינו נותן לך יעד שימור להגדיר; השימור המתקבל תלוי בגורם הקלות של ברירת המחדל ובאופן שאתה מדרג כרטיסים. FSRS מאפשר לך לבחור את היעד שלך במפורש — 70%, 90%, 95% — ומתאים את המרווחים כדי לשמרו. יעדים גבוהים יותר משמעם מרווחים קצרים יותר וחזרות רבות יותר; יעדים נמוכים יותר משמעם מרווחים ארוכים יותר ושכחה רבה יותר. שליטה מפורשת על פשרה זו שימושית כשיש לך דעות נחרצות לגבי כמה אמין צריך להיות השליפה שלך, כגון עבור הסמכה מקצועית לעומת לימוד שפה מזדמן.
בחירה ביניהם
אם אתה מתחיל מחדש ומערכת הלימוד שלך תומכת ב־FSRS, אין סיבה רבה להשתמש ב־SM-2. הגישה מבוססת־המודל מדויקת יותר, מסתגלת יותר, ומפיקה תוצאות טובות יותר בקנה מידה. עקומת הלמידה עבור המשתמש מינימלית — אתה עדיין מדרג כרטיסים באותו אופן; האלגוריתם פשוט משתמש בדירוגים האלה בצורה חכמה יותר.
אם יש לך חבילת SM-2 קיימת עם שנים של היסטוריית חזרות, הגירה ל־FSRS עשויה להיות פשוטה או לא, תלוי בכלי שלך. חלק מהמערכות יכולות לאמוד יציבות FSRS מהיסטוריית SM-2; אחרות מתחילות מחדש. כדאי לבדוק את מסלול ההגירה לפני ההתחייבות.
עבור כל מי שרציני לגבי שליפה פעילה כתרגול ארוך טווח, האלגוריתם הופך לחשוב יותר ויותר ככל שהחבילה גדלה. כמה מאות כרטיסים שנסקרים באופן מזדמן עשויים שלא לחשוף את ההבדל; עשרות אלפי כרטיסים הנלמדים לאורך שנים גורמים לכל רווח יעילות להצטבר באופן משמעותי.
אלגוריתם התזמון הטוב ביותר הוא זה שתשתמש בו בפועל באופן עקבי. אך בהינתן מחויבות שווה, FSRS מפיק לוחות מדויקים יותר, שליטת שימור מפורשת יותר, ויעילות טובה יותר בקנה מידה.
אלגוריתמי תזמון ולולאת הלמידה הרחבה
כדאי לזכור שתזמון הוא רכיב אחד של מערכת למידה, לא כולה. איכות הכרטיסיות שאתה סוקר, מידת המעורבות שלך בקריאה הראשונית, עומק ההבנה שאתה מביא לכל ניסיון שליפה — הגורמים האלה מתקשרים עם אלגוריתם התזמון כדי לקבוע את תוצאות הלמידה בפועל. כרטיס בינוני המתוזמן בצורה מושלמת הוא עדיין כרטיס בינוני.
הערך של FSRS הוא שהוא מסיר את צוואר הבקבוק של התזמון. ברגע שהאלגוריתם ממדל במדויק את הזיכרון שלך וקובע מרווחים כראוי, המשתנים הנותרים בשליטתך: כיצד אתה קורא, כיצד אתה מייצר כרטיסים, כמה בכנות אתה מדרג, וכמה בעקביות אתה מתייצב לחזרות.
LearnBook משתמש ב־FSRS לכל אורכו — כך שכאשר אתה סוקר חומר ממספר מקורות בו־זמנית, כל כרטיס בתור חוצה־הספרים נושא מרווח מכויל באופן עצמאי משלו ולא נכפה עליו לוח משותף. כדי לראות את FSRS בפעולה בתוך זרימת העבודה המלאה של הלימוד, קרא על כיצד כרטיסיות ובחנים נוצרים ומתוזמנים.
שיתוף
Related Posts
חזרה מרווחת ו-FSRS
FSRS חוזה מתי תשכחו כל כרטיס ומתזמן את החזרות בהתאם. מבט ברור על המודל שמאחורי החזרות של LearnBook.
2026-06-18T16:10:50+08:00
חזרה מרווחת ו-FSRS
חזרה מרווחת מתזמנת חזרות במרווחים הולכים וגדלים, ממש לפני שתשכחו. הנה איך זה עובד ומדוע זה כל כך יעיל.
2026-06-18T16:10:50+08:00