Loading page
Repetición espaciada y FSRSpublicado el
FSRS frente a SM-2: por qué importa tu algoritmo de programación
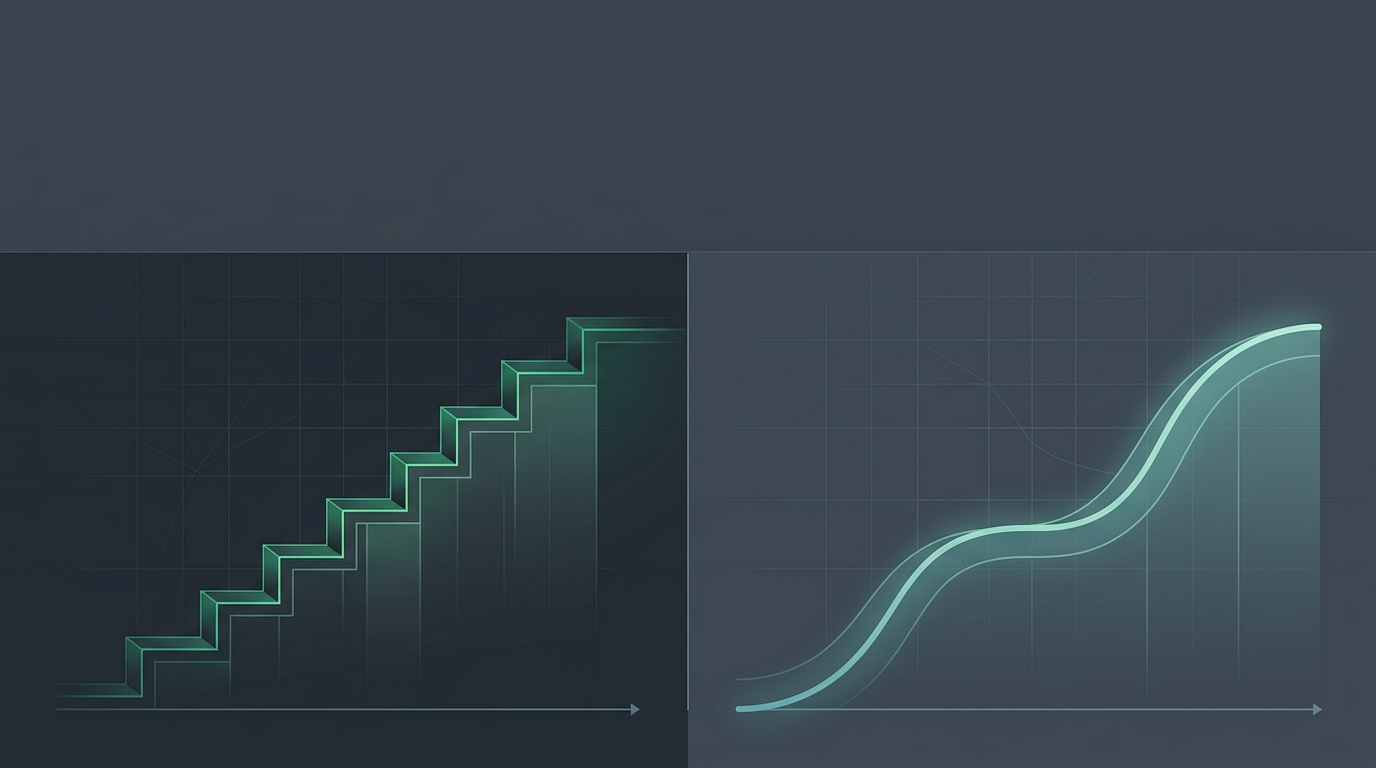
Si has usado Anki, has sido planificado por SM-2. Si has usado un sistema más reciente con "planificación optimizada", es posible que te hayas topado con FSRS. Ambos algoritmos sirven al mismo propósito — decidir cuándo mostrarte cada tarjeta de memoria a continuación — pero lo hacen de maneras fundamentalmente diferentes. La diferencia importa más de lo que la mayoría de los estudiantes piensan, porque tu algoritmo de planificación determina cuánto tiempo pasas repasando, qué tan bien retienes realmente el material y cómo responde el sistema cuando tu memoria se comporta de forma inesperada. Para tener contexto sobre todas las opciones de repetición espaciada disponibles, explora la colección de guías sobre repetición espaciada.
SM-2: la heurística clásica
SM-2 fue desarrollado por Piotr Wozniak en los años ochenta para SuperMemo y ha sido el algoritmo de planificación predeterminado en Anki desde su creación. Su diseño refleja las limitaciones de su época: necesitaba ser lo bastante simple como para ejecutarse en los primeros ordenadores personales y lo bastante explicable como para que los usuarios lo entendieran manualmente.
SM-2 funciona aproximadamente así. Cada tarjeta lleva un factor de facilidad — un multiplicador que comienza en un valor predeterminado (normalmente 2,5) y se ajusta según tus calificaciones. Tras los dos pasos iniciales de aprendizaje (que usan intervalos cortos fijos), el siguiente intervalo se calcula multiplicando el intervalo anterior por el factor de facilidad. Si calificas una tarjeta como Difícil, el factor de facilidad disminuye, acortando los intervalos futuros. Si la calificas como Fácil, aumenta ligeramente, extendiéndolos. Una tarjeta con la que tienes dificultades repetidamente acumula gradualmente un factor de facilidad bajo y se repasa con más frecuencia; una tarjeta que aciertas de forma constante se empuja más lejos hacia el futuro.
Este diseño funciona lo bastante bien como para ser genuinamente útil — millones de estudiantes han construido conocimiento sustancial usando SM-2. Pero tiene limitaciones estructurales que se hacen evidentes cuando estudias a gran escala o analizas los supuestos subyacentes.
Limitaciones clave de SM-2
- Deriva del factor de facilidad. Una vez que un factor de facilidad disminuye — mediante calificaciones de Difícil u Otra vez — tiende a permanecer bajo. Las tarjetas pueden quedar "atrapadas" en intervalos cortos incluso después de que el estudiante haya interiorizado claramente el material, lo que conduce a un exceso de repaso de memorias estables.
- Sin modelo explícito del olvido. SM-2 no predice cuándo olvidarás; aplica un multiplicador heurístico al intervalo anterior. La planificación resultante puede alinearse o no con el decaimiento real de la memoria para una tarjeta y un estudiante determinados.
- Supuesto de decaimiento uniforme. El algoritmo asume que todas las tarjetas decaen a ritmos similares, ajustados únicamente por el factor de facilidad. No tiene noción de distintos niveles de estabilidad que surgen del historial y el patrón de repasos pasados.
- Rigidez en el arranque en frío. Cada tarjeta nueva comienza con el mismo factor de facilidad predeterminado, sin importar cómo se haya manejado contenido similar en el pasado. El sistema no aprende tus patrones a través de las tarjetas.
FSRS: un modelo de memoria, no una heurística
FSRS — el Free Spaced Repetition Scheduler — parte de un punto de partida diferente. En lugar de definir reglas sobre cómo deberían cambiar los intervalos, construye un modelo matemático de la memoria misma y deriva los intervalos a partir de ese modelo. El algoritmo es de código abierto y revisado por pares; consulta el repositorio de código abierto de FSRS para la especificación técnica.
Como se describe con más detalle en Cómo funciona FSRS, el modelo rastrea tres magnitudes para cada tarjeta: dificultad (dureza intrínseca para este estudiante), estabilidad (con qué lentitud decae la memoria) y recuperabilidad (probabilidad de recuerdo exitoso en este momento). El siguiente repaso se programa para el momento en que se predice que la recuperabilidad alcanzará un umbral objetivo — comúnmente el 90 %.
Como el modelo hace predicciones explícitas sobre la probabilidad de recuerdo, puede fijar intervalos que son largos cuando la memoria es genuinamente estable y cortos cuando es frágil — decisiones que SM-2 solo puede aproximar mediante su mecanismo de factor de facilidad.
Comparación frente a frente
| Propiedad | SM-2 | FSRS |
|---|---|---|
| Mecanismo central | Heurística de factor de facilidad aplicada al intervalo anterior | Modelo de memoria que predice la recuperabilidad en el tiempo |
| Derivación del intervalo | Intervalo anterior × factor de facilidad | Tiempo hasta que la recuperabilidad cae al umbral objetivo |
| Objetivo de retención | Implícito — sin probabilidad de retención explícita | Explícito — objetivo configurable (p. ej. 90 %) |
| Adaptación por estudiante | Solo ajustes del factor de facilidad por tarjeta | Los pesos del modelo pueden ajustarse al historial individual de repasos |
| Deriva del factor de facilidad | Sí — los factores de facilidad bajos tienden a persistir | No aplica — la estabilidad reemplaza al factor de facilidad |
| Señal de calificación utilizada | Ajusta el factor de facilidad y el multiplicador del intervalo | Actualiza la estabilidad y la dificultad; vuelve a derivar el intervalo |
| Transparencia | Reglas simples, fáciles de explicar manualmente | Modelo más complejo, pero con predicciones de retención explícitas |
| Eficiencia de repaso | Buena para la mayoría de los casos de uso | Generalmente menos repasos para una retención equivalente |
Por qué el algoritmo afecta a la eficiencia del repaso
La diferencia de eficiencia de repaso entre los dos algoritmos se reduce a qué tan bien rastrea cada uno el estado real de tu memoria. SM-2 usa un sustituto — el factor de facilidad y su acumulación a lo largo de los repasos pasados — que se correlaciona con la estabilidad de la memoria pero no la mide directamente. El resultado es una planificación que es razonable en promedio pero imprecisa para tarjetas individuales.
FSRS, al rastrear la estabilidad de forma explícita, puede distinguir entre dos situaciones que SM-2 trata de forma similar: una tarjeta con un factor de facilidad bajo que has consolidado recientemente mediante una racha de repasos de Bien, y una tarjeta con un factor de facilidad bajo que sigue siendo genuinamente frágil. SM-2 le dará a ambas aproximadamente el mismo intervalo corto; FSRS le dará a la tarjeta consolidada un intervalo más largo porque su estabilidad ha crecido.
A lo largo de un mazo grande estudiado durante meses, esta precisión se acumula. Las memorias estables no se repasan innecesariamente; las memorias frágiles se repasan antes de que caigan por debajo del umbral de retención. El efecto neto es una cola de repaso más pequeña y mejor enfocada, lo que significa menos tiempo dedicado a repasar manteniendo la misma — o mayor — retención real.
Compensaciones y consideraciones prácticas
SM-2 no carece de ventajas. Es extremadamente transparente: puedes leer el algoritmo en unas pocas líneas y entender exactamente qué hará a continuación. Tiene décadas de validación en el mundo real. Y para estudiantes con mazos pequeños o calendarios de estudio cortos, la diferencia de eficiencia entre SM-2 y FSRS puede ser insignificante en la práctica.
FSRS introduce más complejidad. El modelo tiene parámetros que necesitan valores predeterminados sensatos — e idealmente, calibración con tus datos. Requiere una disciplina de calificación consistente, porque las calificaciones inexactas confunden a un modelo más de lo que confunden a una heurística. Para un estudiante que califica las tarjetas sin cuidado o usa un enfoque binario de aprobado/suspenso, la ventaja de FSRS se reduce significativamente.
La otra consideración importante es lo que significa "retención" en cada sistema. SM-2 no te da un objetivo de retención que fijar; la retención resultante depende del factor de facilidad predeterminado y de cómo calificas las tarjetas. FSRS te permite elegir tu objetivo de forma explícita — 70 %, 90 %, 95 % — y ajusta los intervalos para mantenerlo. Objetivos más altos significan intervalos más cortos y más repasos; objetivos más bajos significan intervalos más largos y mayor olvido. Tener un control explícito sobre esta compensación es útil cuando tienes opiniones firmes sobre qué tan fiable necesita ser tu recuerdo, como para una certificación profesional frente al aprendizaje casual de un idioma.
Cómo elegir entre ellos
Si empiezas desde cero y tu sistema de estudio admite FSRS, hay pocas razones para usar SM-2. El enfoque basado en modelos es más preciso, más adaptable y produce mejores resultados a gran escala. La curva de aprendizaje para el usuario es mínima — sigues calificando las tarjetas de la misma manera; el algoritmo simplemente usa esas calificaciones de forma más inteligente.
Si tienes un mazo SM-2 existente con años de historial de repasos, migrar a FSRS puede ser sencillo o no, dependiendo de tu herramienta. Algunos sistemas pueden estimar la estabilidad de FSRS a partir del historial de SM-2; otros empiezan desde cero. Vale la pena comprobar la ruta de migración antes de comprometerse.
Para cualquiera que se tome en serio el recuerdo activo como práctica a largo plazo, el algoritmo importa cada vez más a medida que crece el mazo. Unos pocos cientos de tarjetas repasadas de manera informal pueden no revelar la diferencia; decenas de miles de tarjetas estudiadas durante años hacen que cada ganancia de eficiencia se acumule de forma significativa.
El mejor algoritmo de planificación es el que realmente usarás de forma consistente. Pero a igual compromiso, FSRS produce planificaciones más precisas, un control de retención más explícito y mejor eficiencia a gran escala.
Los algoritmos de planificación y el bucle de aprendizaje más amplio
Conviene recordar que la planificación es un componente de un sistema de aprendizaje, no la totalidad de él. La calidad de las tarjetas que repasas, tu implicación durante la lectura inicial, la profundidad de comprensión que aportas a cada intento de recuerdo — estos factores interactúan con el algoritmo de planificación para determinar los resultados reales de aprendizaje. Una tarjeta mediocre planificada a la perfección sigue siendo una tarjeta mediocre.
El valor de FSRS es que elimina el cuello de botella de la planificación. Una vez que el algoritmo está modelando con precisión tu memoria y fijando intervalos apropiadamente, las variables restantes están bajo tu control: cómo lees, cómo generas tarjetas, con qué honestidad calificas y con qué constancia te presentas a los repasos.
LearnBook usa FSRS en todo momento — así que cuando estás repasando material de múltiples fuentes a la vez, cada tarjeta en la cola entre libros lleva su propio intervalo calibrado de forma independiente en lugar de ser forzada a una planificación compartida. Para ver FSRS en práctica dentro del flujo de estudio completo, lee sobre cómo se generan y planifican las tarjetas de memoria y los cuestionarios.
Compartir
Related Posts
Repetición espaciada y FSRS
FSRS predice cuándo olvidarás cada tarjeta y programa los repasos en consecuencia. Una mirada clara al modelo que hay detrás de los repasos de LearnBook.
2026-06-18T15:26:31+08:00
Repetición espaciada y FSRS
La repetición espaciada programa los repasos a intervalos crecientes, justo antes de que olvidaras. Aquí verás cómo funciona y por qué es tan eficaz.
2026-06-18T15:26:31+08:00