Loading page
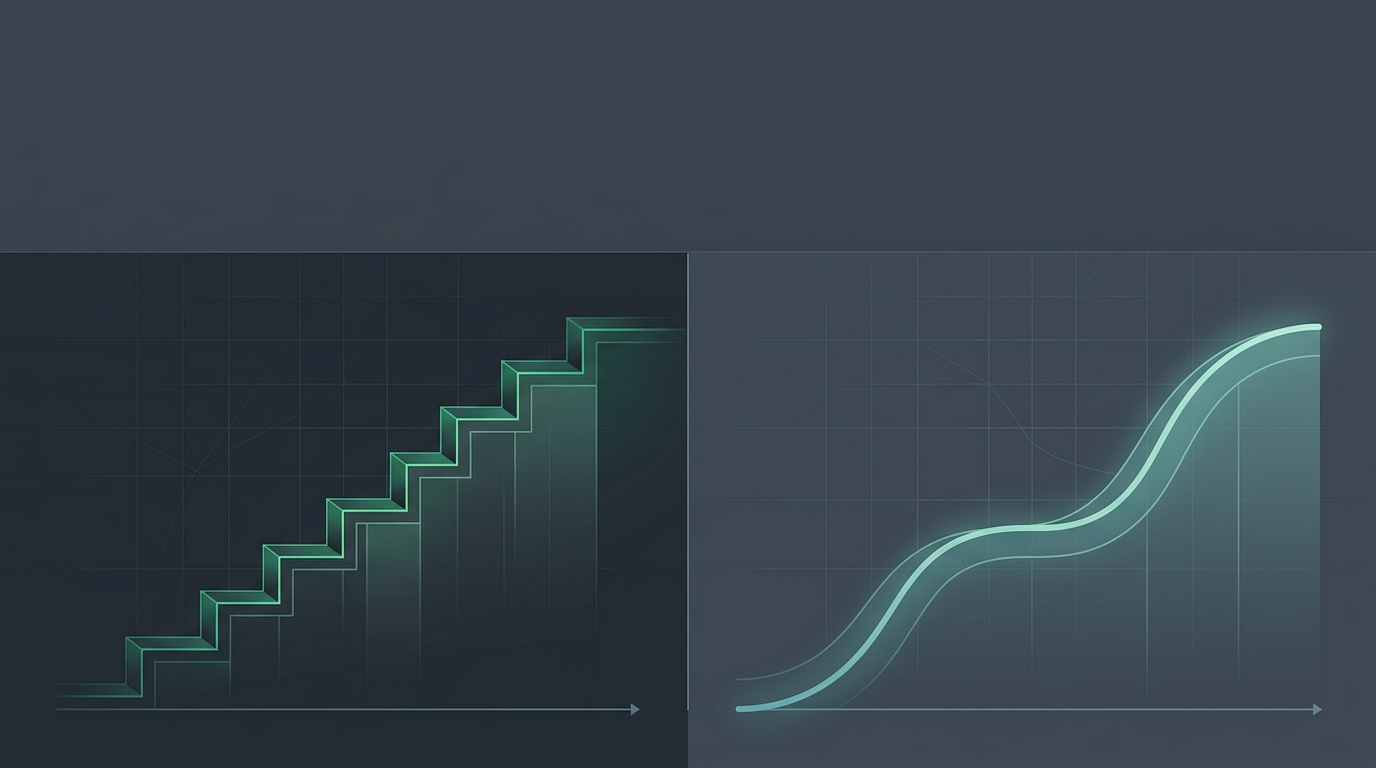
Verteiltes Wiederholen & FSRSveröffentlicht am
FSRS vs. SM-2: Warum dein Planungsalgorithmus zählt
Wenn du Anki verwendet hast, wurdest du von SM-2 geplant. Wenn du ein neueres System mit „optimierter Planung" verwendet hast, bist du vielleicht FSRS begegnet. Beide Algorithmen dienen demselben Zweck – sie entscheiden, wann dir jede Karteikarte als Nächstes gezeigt wird – aber sie tun es auf grundlegend unterschiedliche Weise. Der Unterschied ist bedeutsamer, als die meisten Lernenden ahnen, denn dein Planungsalgorithmus bestimmt, wie viel Zeit du mit Wiederholen verbringst, wie gut du das Material tatsächlich behältst und wie das System reagiert, wenn sich dein Gedächtnis unerwartet verhält. Für einen Überblick über alle verfügbaren Optionen des verteilten Wiederholens durchstöbere die Ratgebersammlung zu verteiltem Wiederholen.
SM-2: Die klassische Heuristik
SM-2 wurde in den 1980er-Jahren von Piotr Wozniak für SuperMemo entwickelt und ist seit der Entstehung von Anki dessen Standard-Planungsalgorithmus. Sein Design spiegelt die Beschränkungen seiner Zeit wider: Er musste einfach genug sein, um auf frühen Heimcomputern zu laufen, und nachvollziehbar genug, damit Nutzer ihn manuell verstehen konnten.
SM-2 funktioniert grob wie folgt. Jede Karte trägt einen Leichtigkeitsfaktor – einen Multiplikator, der bei einem Standardwert (typischerweise 2,5) beginnt und sich anhand deiner Bewertungen anpasst. Nach den ersten beiden Lernschritten (die feste kurze Intervalle verwenden) wird das nächste Intervall berechnet, indem das vorherige Intervall mit dem Leichtigkeitsfaktor multipliziert wird. Wenn du eine Karte mit Schwer bewertest, sinkt der Leichtigkeitsfaktor und verkürzt künftige Intervalle. Wenn du sie mit Leicht bewertest, steigt er leicht und verlängert sie. Eine Karte, mit der du wiederholt Mühe hast, sammelt allmählich einen niedrigen Leichtigkeitsfaktor an und wird häufiger wiederholt; eine Karte, die du durchgängig triffst, wird weiter in die Zukunft geschoben.
Dieses Design funktioniert gut genug, um wirklich nützlich zu sein – Millionen von Lernenden haben mit SM-2 beträchtliches Wissen aufgebaut. Aber es hat strukturelle Grenzen, die deutlich werden, wenn man in großem Umfang lernt oder die zugrunde liegenden Annahmen analysiert.
Zentrale Grenzen von SM-2
- Drift des Leichtigkeitsfaktors. Sobald ein Leichtigkeitsfaktor sinkt – durch Bewertungen mit Schwer oder Nochmal – bleibt er tendenziell niedrig. Karten können in kurzen Intervallen „gefangen" bleiben, selbst nachdem der Lernende das Material eindeutig verinnerlicht hat, was zu einer Überwiederholung stabiler Gedächtnisinhalte führt.
- Kein explizites Vergessensmodell. SM-2 sagt nicht voraus, wann du vergessen wirst; es wendet einen heuristischen Multiplikator auf das vorherige Intervall an. Der resultierende Zeitplan kann mit dem tatsächlichen Gedächtnisverfall für eine bestimmte Karte und einen bestimmten Lernenden übereinstimmen oder auch nicht.
- Annahme eines einheitlichen Verfalls. Der Algorithmus nimmt an, dass alle Karten mit ähnlichen Raten verfallen, lediglich angepasst durch den Leichtigkeitsfaktor. Er kennt kein Konzept unterschiedlicher Stabilitätsniveaus, die sich aus der Geschichte und dem Muster vergangener Wiederholungen ergeben.
- Starrheit beim Kaltstart. Jede neue Karte beginnt mit demselben Standard-Leichtigkeitsfaktor, unabhängig davon, wie ähnliche Inhalte in der Vergangenheit gehandhabt wurden. Das System lernt deine Muster über Karten hinweg nicht.
FSRS: Ein Gedächtnismodell, keine Heuristik
FSRS – der Free Spaced Repetition Scheduler – wählt einen anderen Ausgangspunkt. Statt Regeln dafür zu definieren, wie sich Intervalle ändern sollen, baut er ein mathematisches Modell des Gedächtnisses selbst auf und leitet die Intervalle aus diesem Modell ab. Der Algorithmus ist Open Source und peer-reviewed; siehe das Open-Source-Repository von FSRS für die technische Spezifikation.
Wie ausführlicher in Wie FSRS funktioniert beschrieben, verfolgt das Modell drei Größen für jede Karte: Schwierigkeit (inhärente Schwierigkeit für diesen Lernenden), Stabilität (wie langsam das Gedächtnis verfällt) und Abrufbarkeit (Wahrscheinlichkeit eines erfolgreichen Abrufs in diesem Moment). Die nächste Wiederholung wird für den Zeitpunkt geplant, zu dem die Abrufbarkeit voraussichtlich einen Zielschwellenwert erreicht – üblicherweise 90 %.
Da das Modell explizite Vorhersagen über die Abrufwahrscheinlichkeit trifft, kann es Intervalle setzen, die lang sind, wenn das Gedächtnis wirklich stabil ist, und kurz, wenn es fragil ist – Entscheidungen, die SM-2 über seinen Leichtigkeitsfaktor-Mechanismus nur annähern kann.
Direkter Vergleich
| Eigenschaft | SM-2 | FSRS |
|---|---|---|
| Kernmechanismus | Leichtigkeitsfaktor-Heuristik, angewendet auf das vorherige Intervall | Gedächtnismodell, das die Abrufbarkeit über die Zeit vorhersagt |
| Intervallableitung | Vorheriges Intervall × Leichtigkeitsfaktor | Zeit, bis die Abrufbarkeit auf den Zielschwellenwert sinkt |
| Behaltenssteuerung | Implizit – keine explizite Behaltenswahrscheinlichkeit | Explizit – konfigurierbares Ziel (z. B. 90 %) |
| Anpassung pro Lernendem | Nur kartenspezifische Anpassungen des Leichtigkeitsfaktors | Modellgewichte können an den individuellen Wiederholungsverlauf angepasst werden |
| Drift des Leichtigkeitsfaktors | Ja – niedrige Leichtigkeitsfaktoren bleiben tendenziell bestehen | Nicht zutreffend – die Stabilität ersetzt den Leichtigkeitsfaktor |
| Verwendetes Bewertungssignal | Passt Leichtigkeitsfaktor und Intervallmultiplikator an | Aktualisiert Stabilität und Schwierigkeit; leitet das Intervall neu ab |
| Transparenz | Einfache Regeln, manuell leicht zu erklären | Komplexeres Modell, aber explizite Behaltensvorhersagen |
| Wiederholungseffizienz | Gut für die meisten Anwendungsfälle | Im Allgemeinen weniger Wiederholungen für gleichwertiges Behalten |
Warum der Algorithmus die Wiederholungseffizienz beeinflusst
Der Unterschied in der Wiederholungseffizienz zwischen den beiden Algorithmen läuft darauf hinaus, wie gut jeder von ihnen den tatsächlichen Zustand deines Gedächtnisses erfasst. SM-2 verwendet einen Näherungswert – den Leichtigkeitsfaktor und seine Anhäufung über vergangene Wiederholungen – der mit der Gedächtnisstabilität korreliert, sie aber nicht direkt misst. Das Ergebnis ist ein Zeitplan, der im Durchschnitt vernünftig, für einzelne Karten aber ungenau ist.
FSRS kann durch die explizite Verfolgung der Stabilität zwischen zwei Situationen unterscheiden, die SM-2 ähnlich behandelt: eine Karte mit niedrigem Leichtigkeitsfaktor, die du kürzlich durch eine Reihe von Gut-Wiederholungen konsolidiert hast, und eine Karte mit niedrigem Leichtigkeitsfaktor, die wirklich fragil bleibt. SM-2 gibt beiden ungefähr dasselbe kurze Intervall; FSRS gibt der konsolidierten Karte ein längeres Intervall, weil ihre Stabilität gewachsen ist.
Über einen großen Stapel, der über Monate gelernt wird, summiert sich diese Präzision. Stabile Gedächtnisinhalte werden nicht unnötig wiederholt; fragile Gedächtnisinhalte werden wiederholt, bevor sie unter den Behaltensschwellenwert fallen. Der Nettoeffekt ist eine Wiederholungswarteschlange, die kleiner und besser ausgerichtet ist, was weniger Wiederholungszeit bedeutet, während dasselbe – oder ein höheres – tatsächliches Behalten erhalten bleibt.
Abwägungen und praktische Überlegungen
SM-2 ist nicht ohne Vorteile. Es ist äußerst transparent: Du kannst den Algorithmus in wenigen Zeilen lesen und genau verstehen, was er als Nächstes tun wird. Er hat jahrzehntelange Validierung in der Praxis. Und für Lernende mit kleinen Stapeln oder kurzen Lernzeiträumen mag der Effizienzunterschied zwischen SM-2 und FSRS in der Praxis vernachlässigbar sein.
FSRS bringt mehr Komplexität mit sich. Das Modell hat Parameter, die sinnvolle Standardwerte benötigen – und idealerweise eine Kalibrierung auf deine Daten. Es erfordert eine konsequente Bewertungsdisziplin, denn ungenaue Bewertungen führen ein Modell stärker in die Irre als eine Heuristik. Für einen Lernenden, der Karten nachlässig bewertet oder einen binären Bestanden/Nicht-bestanden-Ansatz verwendet, schrumpft der Vorteil von FSRS erheblich.
Die andere wichtige Überlegung ist, was „Behalten" in jedem System bedeutet. SM-2 gibt dir kein Behaltensziel zum Festlegen; das resultierende Behalten hängt vom Standard-Leichtigkeitsfaktor und davon ab, wie du Karten bewertest. FSRS lässt dich dein Ziel explizit wählen – 70 %, 90 %, 95 % – und passt die Intervalle an, um es zu halten. Höhere Ziele bedeuten kürzere Intervalle und mehr Wiederholungen; niedrigere Ziele bedeuten längere Intervalle und mehr Vergessen. Explizite Kontrolle über diese Abwägung zu haben, ist nützlich, wenn du klare Vorstellungen davon hast, wie zuverlässig dein Abruf sein muss, etwa für eine berufliche Zertifizierung im Vergleich zum beiläufigen Sprachenlernen.
Die Wahl zwischen beiden
Wenn du neu anfängst und dein Lernsystem FSRS unterstützt, gibt es kaum einen Grund, SM-2 zu verwenden. Der modellbasierte Ansatz ist genauer, anpassungsfähiger und liefert bessere Ergebnisse im großen Maßstab. Die Lernkurve für den Nutzer ist minimal – du bewertest Karten weiterhin auf dieselbe Weise; der Algorithmus nutzt diese Bewertungen nur intelligenter.
Wenn du einen bestehenden SM-2-Stapel mit jahrelangem Wiederholungsverlauf hast, kann die Migration zu FSRS je nach Werkzeug unkompliziert sein oder auch nicht. Manche Systeme können die FSRS-Stabilität aus dem SM-2-Verlauf schätzen; andere beginnen neu. Es lohnt sich, den Migrationspfad zu prüfen, bevor man sich festlegt.
Für alle, denen aktives Erinnern als langfristige Praxis wichtig ist, gewinnt der Algorithmus zunehmend an Bedeutung, je größer der Stapel wird. Ein paar Hundert beiläufig wiederholte Karten offenbaren den Unterschied vielleicht nicht; Zehntausende über Jahre gelernte Karten lassen jeden Effizienzgewinn bedeutsam aufsummieren.
Der beste Planungsalgorithmus ist der, den du tatsächlich konsequent verwenden wirst. Aber bei gleichem Engagement erzeugt FSRS genauere Zeitpläne, eine explizitere Behaltenssteuerung und eine bessere Effizienz im großen Maßstab.
Planungsalgorithmen und der weitere Lernkreislauf
Es lohnt sich, daran zu denken, dass die Planung eine Komponente eines Lernsystems ist, nicht das Ganze. Die Qualität der Karteikarten, die du wiederholst, dein Engagement beim ersten Lesen, die Tiefe des Verständnisses, die du in jeden Abrufversuch einbringst – diese Faktoren wirken mit dem Planungsalgorithmus zusammen und bestimmen die tatsächlichen Lernergebnisse. Eine mittelmäßige Karte, perfekt geplant, ist immer noch eine mittelmäßige Karte.
Der Wert von FSRS besteht darin, dass es den Planungsengpass beseitigt. Sobald der Algorithmus dein Gedächtnis genau modelliert und die Intervalle angemessen setzt, liegen die verbleibenden Variablen in deiner Hand: wie du liest, wie du Karten erzeugst, wie ehrlich du bewertest und wie konsequent du zu den Wiederholungen erscheinst.
LearnBook verwendet durchgehend FSRS – wenn du also Material aus mehreren Quellen gleichzeitig wiederholst, trägt jede Karte in der buchübergreifenden Warteschlange ihr eigenes unabhängig kalibriertes Intervall, statt in einen gemeinsamen Zeitplan gezwungen zu werden. Um FSRS im vollständigen Lern-Workflow in der Praxis zu sehen, lies darüber, wie Karteikarten und Quizze erzeugt und geplant werden.
Teilen
Related Posts
Verteiltes Wiederholen & FSRS
FSRS sagt vorher, wann du jede Karte vergisst, und plant die Wiederholungen entsprechend. Ein klarer Blick auf das Modell hinter den Wiederholungen von LearnBook.
2026-06-18T15:26:04+08:00
Verteiltes Wiederholen & FSRS
Verteiltes Wiederholen plant Wiederholungen in wachsenden Abständen, genau bevor du vergessen würdest. So funktioniert es und warum es so wirksam ist.
2026-06-18T15:26:04+08:00